Stefan Vaskevich
Ferramentas usadas neste artigo

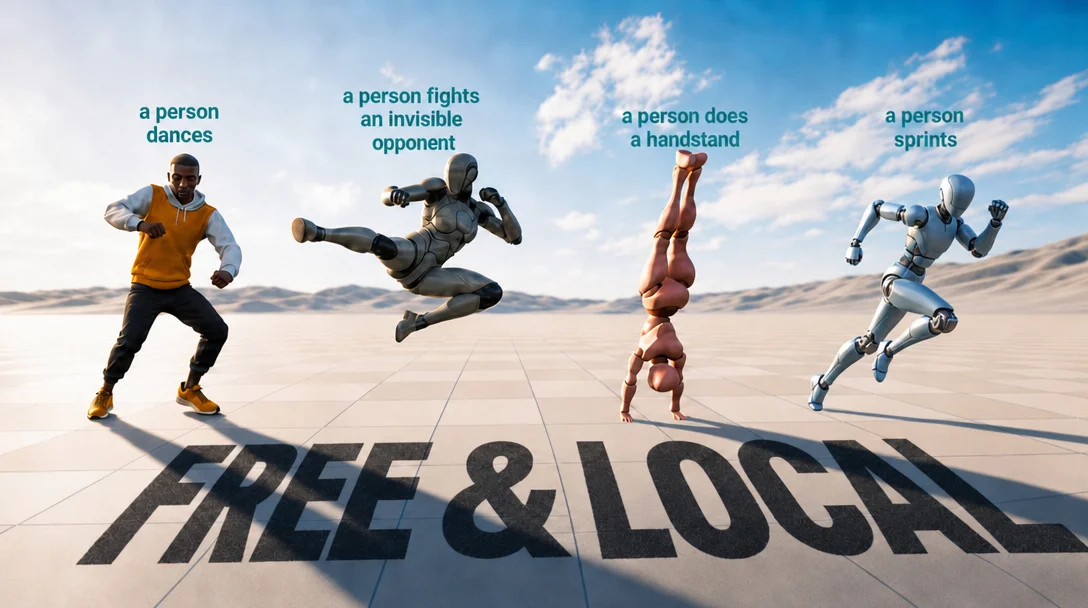
Você digita "uma pessoa executa um chute giratório de artes marciais" e obtém uma animação utilizável, na sua própria máquina, sem ambiente Python e sem chamadas de rede. Esse é o Kimodo, o modelo de difusão de movimento da NVIDIA, e alguém o portou para C++ e GGML para que rode no Vulkan ou em um processador comum com menos de 2 GB de memória.
Passei um dia instalando o Kimodo do zero no Windows, gerando clipes, aplicando-os a rigs do Mixamo e importando-os para a Unreal Engine. Este guia traz tudo o que aprendi, incluindo as duas coisas que mais me custaram tempo e não estão em nenhum README: quais modelos você realmente tem permissão para usar e por que tudo é limitado pelo seu disco, e não pela sua placa de vídeo.
1. O que é o Kimodo e o que o port em C++ mudou
A NVIDIA lançou o Kimodo em março de 2026. Ele é um modelo cinemático de difusão de movimento treinado em 700 horas de captura de movimento óptica licenciada comercialmente, e transforma prompts de texto e restrições cinemáticas esparsas em movimento 3D de humanos e robôs humanoides. Ele é fornecido em três formatos de esqueleto: o corpo paramétrico SOMA da própria NVIDIA, o robô humanoide Unitree G1 e o SMPL-X.
A versão original é um projeto em PyTorch. Você precisava de toda a stack do CUDA funcionando antes de conseguir gerar um único clipe, o que é uma barreira real para quem tem uma máquina configurada para trabalhar com 3D, e não com aprendizado de máquina.
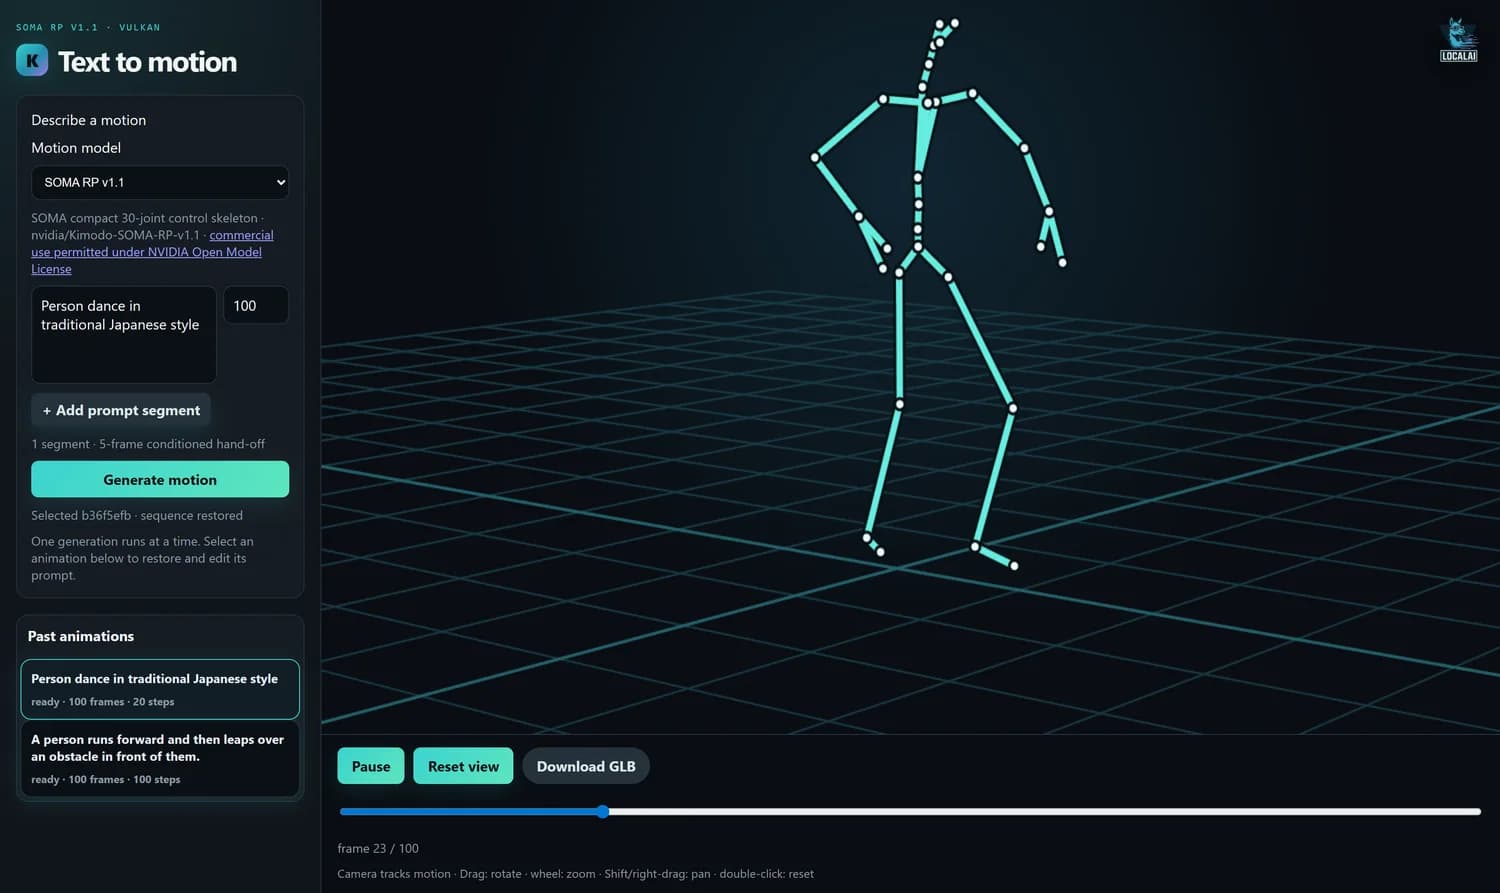
O kimodo.cpp é um port nativo em C++ que usa GGML. Ele carrega pesos GGUF, roda com Vulkan ou no processador e inclui uma pequena interface local acessível pelo navegador. Sem Python na hora da geração, sem CUDA, sem rede. É basicamente isso, e é mais importante do que parece, porque o Kimodo deixa de ser "uma coisa que o pessoal de aprendizado de máquina roda" e passa a ser "uma coisa que abre na sua estação de trabalho".
2. A situação da licença, que mudou em 26 de agosto
Esta é a parte que a maioria dos artigos erra, porque isso mudou recentemente e mudou em ambas as direções ao mesmo tempo.
O port originalmente incluía os pesos convertidos do SMPL-X. Eles foram retirados. O autor percebeu que a licença original da NVIDIA para aquele checkpoint específico proíbe explicitamente a distribuição de modelos derivados e removeu o GGUF, o manifesto e as somas de verificação. A ficha do modelo que os substituiu explica isso claramente em vez de deixar um 404 misterioso para trás, o que apreciei mais do que esperava.
Quase no mesmo momento, outros quatro checkpoints foram disponibilizados sob uma licença completamente diferente, e o suporte a eles chegou ao port.
| Modelo | Esqueleto | Licença | Uso comercial |
|---|---|---|---|
| SOMA RP v1.1 | SOMA, 30 articulações | NVIDIA Open Model | Permitido |
| SOMA SEED v1.1 | SOMA, 30 articulações | NVIDIA Open Model | Permitido |
| G1 RP v1 | Unitree G1, 34 articulações | NVIDIA Open Model | Permitido |
| G1 SEED v1 | Unitree G1, 34 articulações | NVIDIA Open Model | Permitido |
| SMPL-X RP v1 | SMPL-X, 22 articulações | NVIDIA Internal Scientific R&D | Apenas pesquisa |
A interface é transparente quanto a isso, o que eu não esperava de um port de fim de semana. Escolha um modelo e ela informa sob qual licença você está antes de gerar qualquer coisa.
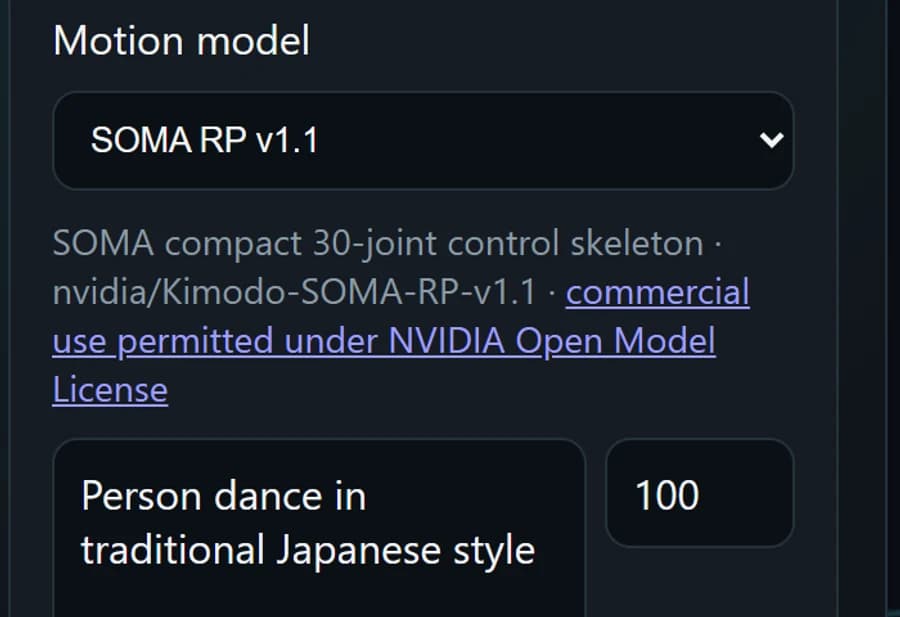
3. De qual hardware você realmente precisa
Os requisitos são baixos, e vale a pena entender por que são baixos em vez de apenas consultar uma tabela.
| Recurso | Mínimo | Confortável |
|---|---|---|
| Espaço livre em disco | 25 GB | 35 GB, em uma unidade NVMe |
| RAM do sistema | 4 GB | 32 GB, e veja a seção 5 |
| VRAM, com GPU | 1.2 GB | 2 GB |
| CPU | 2 núcleos | 6 núcleos |
O pico de memória fica abaixo de 2 GB em qualquer configuração, GPU ou processador. O ajuste é KIMODO_TEXT_LAYER_CHUNK, e o número que ele recebe corresponde a camadas, não gigabytes: o chunk 2 ocupa 1.2 GB de VRAM, o chunk 4 ocupa 1.8 GB e o chunk 8 padrão ocupa 3.5 GB. Aumentá-lo não deixa nada mais rápido, porque o encoder é lido uma vez por execução em qualquer tamanho de chunk.
Existe um limite mínimo de cerca de 1.3 GB. A tabela de embeddings ocupa um único bloco de 1.05 GB que não pode ser dividido, independentemente do tamanho do bloco de camadas. Por isso, abaixo desse limite o programa simplesmente não inicia.
4. Instalando no Windows
A documentação do projeto é voltada ao Linux. O Windows funciona, e o arquivo CMake tem uma ramificação explícita para MSVC, mas há quatro pontos em que você pode perder uma hora. Aqui está a versão resumida, e o passo a passo completo está disponível para download no final desta seção.
Instale a toolchain e depois abra um novo terminal
Git, Visual Studio Build Tools com a carga de trabalho de C++, o Vulkan SDK e Go se você quiser a interface web.
winget install Git.Git
winget install Microsoft.VisualStudio.2022.BuildTools --override "--quiet --wait --norestart --add Microsoft.VisualStudio.Workload.VCTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --includeRecommended"
winget install KhronosGroup.VulkanSDK
winget install GoLang.Go
O componente VC.CMake.Project não é opcional. Sem ele, você tem um compilador, mas não tem CMake nem Ninja, e a mensagem de erro não menciona isso. Depois, feche todos os terminais: o instalador do Vulkan define VULKAN_SDK em todo o sistema, e um terminal que já estiver aberto não terá acesso à variável.
Clone com submódulos
git clone --recurse-submodules https://github.com/localai-org/kimodo.cpp
cd kimodo.cpp
O GGML é um submódulo. Um clone comum o deixa vazio, e baixar o repositório como ZIP não funciona de jeito nenhum pelo mesmo motivo.
Aplique duas correções no código-fonte e compile
Adicione #include <stdexcept> a src/denoiser.cpp, src/generate.cpp e src/llm_tokenizer.cpp, e altere path.c_str() para path.string().c_str() em src/llm_text_encoder.cpp. Ambas estão corretas em todas as plataformas e simplesmente ainda não foram mescladas upstream. Depois, a partir de um terminal onde o vcvars64.bat tenha sido executado:
cmake -S . -B build-win -G Ninja -DCMAKE_BUILD_TYPE=Release -DKIMODO_ENABLE_VULKAN=ON -DKIMODO_BUILD_TESTS=OFF
cmake --build build-winBaixe os pesos
O text encoder é compartilhado por todos os modelos, então é um download único de 15.2 GB. Cada modelo de movimento ocupa apenas cerca de 1.13 GB a mais.
pip install huggingface_hub
hf download LocalAI-io/Llama-3-Kimodo-GGML --local-dir . --include "generated/llm2vec-text-bundle/*"
hf download LocalAI-io/Kimodo-SOMA-RP-v1.1-GGML --local-dir . --include "models/*"
Adicionar todos os quatro modelos de licença aberta ocupa cerca de 4.5 GB, e não quatro vezes 17, porque o encoder é compartilhado.
hf download com --include não encontra nenhuma correspondência e encerra com sucesso. Nenhum erro, nenhum arquivo, exit code zero. Meu script de setup informou uma execução limpa e eu só percebi a falta do modelo quando a geração falhou. Sempre verifique se o .gguf realmente foi parar em models\.Todos os comandos, ambas as correções no código-fonte com os erros exatos que elas evitam, todas as variáveis de ambiente e uma tabela de solução de problemas que mapeia cada sintoma à sua causa real. Escrito depois de fazer isso em uma máquina sem nenhum compilador instalado.
kimodo-windows-setup.md5. Gerando seu primeiro clipe
A linha de comando é posicional, e as DLLs do GGML ficam na pasta bin da árvore de build, em vez de ficarem ao lado do executável. Se deixar isso passar, o programa fecha instantaneamente sem nenhuma saída, o que parece exatamente um crash, mas é o Windows falhando ao carregar uma DLL.
set PATH=%CD%\build-win\bin;%PATH%
build-win\kmd-generate.exe models\kimodo-soma-rp-v1.1-f32.gguf generated\llm2vec-text-bundle prompt.txt 90 20 41 out
Isso são 90 quadros a 30 fps, portanto três segundos, com 20 etapas de denoising e semente 41. Já para a interface web:
go run ./demo -addr 127.0.0.1:8094 -generator build-win/kmd-generate.exeDois números definem a qualidade do que você obtém. Com Frames até cerca de 300, ou dez segundos, o clipe permanece coerente. Com 400 frames, o clipe apresenta jitter e, com 600, se transforma em ruído por volta do frame 300. Embora pareça contraditório, clipes mais curtos saem mais impactantes: o mesmo prompt com 120 frames parece mais nítido e atlético do que com 300, porque o modelo preenche o tempo extra em vez de repetir a ação com mais força.
Steps é a contagem de denoising, e 20 funciona tanto para rascunhos quanto para versões finais. O custo é linear, portanto 100 steps custam cinco vezes mais sem nenhum ganho visível. A interface incluída atualmente traz 100 fixo no código em demo/index.html, o que vale a pena mudar para 20 antes de fazer qualquer coisa séria com ela.
Na minha máquina, um Ryzen 7 7800X3D com 31 GB de RAM e os pesos em um SSD SATA, um clipe de três segundos levou 399 segundos. Desse tempo, cerca de 380 segundos foram gastos na leitura do disco e 10 segundos no processamento pela CPU. A RTX 4070 SUPER ficou ociosa o tempo todo. A unidade estava entregando 40 MB/s, e 15.2 GB a 40 MB/s dá 380 segundos. A conta fecha exatamente.
Duas soluções, em ordem de impacto: coloque os pesos em uma unidade NVMe e libere RAM antes de gerar. O codificador precisa de cerca de 16 GB de espaço livre no cache de arquivos para permanecer no cache. Uma máquina de 32 GB com um navegador e um aplicativo de chat abertos só tem cerca de 7 GB disponíveis para esse cache, então se comporta como uma máquina de 16 GB.
6. Aplicando o movimento a um rig de verdade
Gerar é a parte fácil. Esse port interessa mais a um artista 3D do que a um pesquisador porque o resultado pode ser aplicado ao rig de um personagem comum com pouquíssimo esforço.
A interface web tem um botão Download GLB. O próprio servidor de demonstração cria o glTF, então você recebe um arquivo que abre no Blender já com a hierarquia de ossos e keyframes prontos. Para a maioria dos trabalhos, isso resolve tudo e dispensa os detalhes sobre formatos apresentados abaixo.
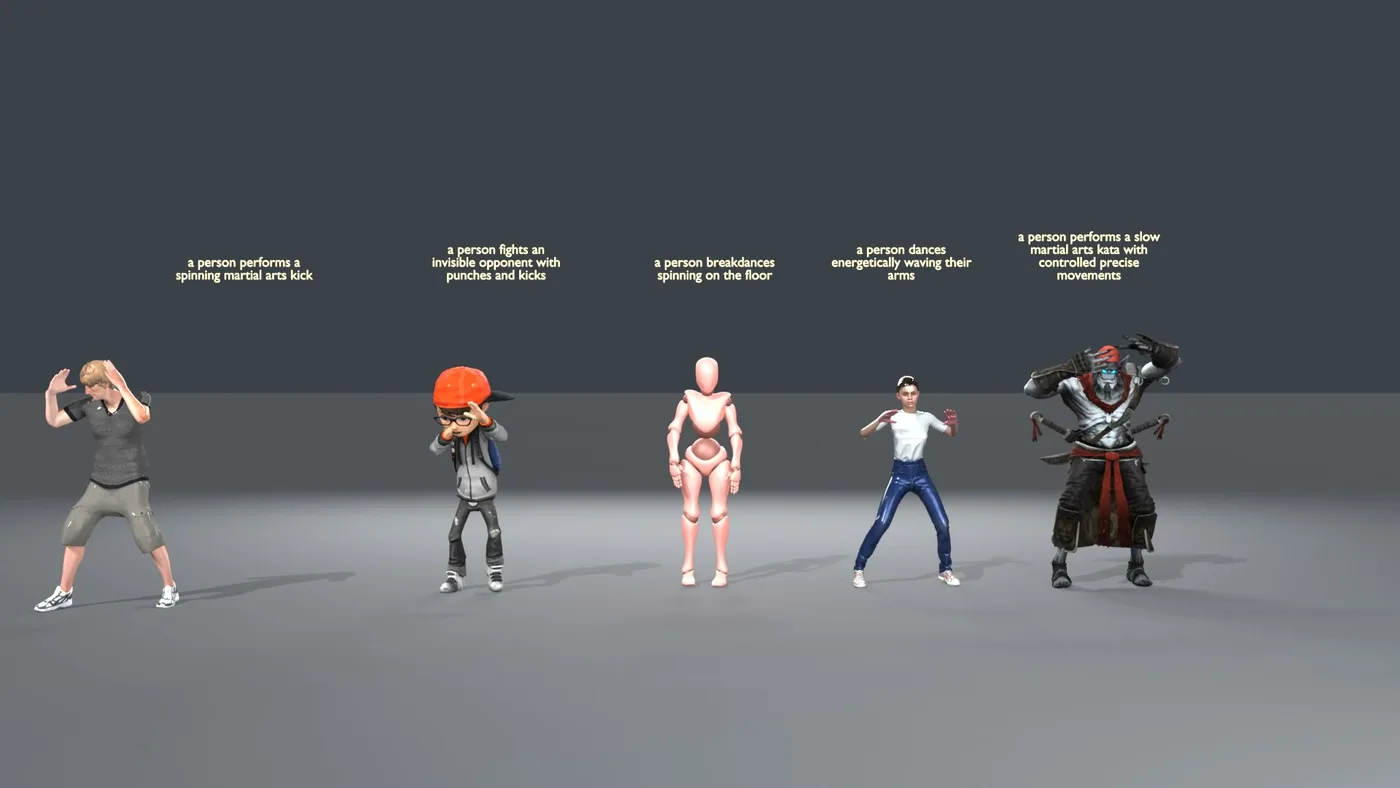
É aqui que o SOMA se mostra uma sorte. Ele não usa a convenção de nomenclatura do SMPL-X de jeito nenhum. Suas 30 articulações são chamadas de Hips, Spine1, LeftShoulder, LeftForeArm e assim por diante, o que segue quase exatamente a convenção do Mixamo. A maioria dos ossos é mapeada apenas adicionando o prefixo mixamorig: e nada mais.
LeftLeg do SOMA é a coxa. O mixamorig:LeftLeg do Mixamo é a canela. O mapeamento correto é o LeftLeg do SOMA para mixamorig:LeftUpLeg, e o LeftShin do SOMA para mixamorig:LeftLeg. Um mapeamento feito apenas por prefixos gera um personagem cujos joelhos dobram a partir do quadril, e essa é a primeira coisa a verificar quando uma transferência parece errada.Para a Unreal, parei de fazer isso manualmente. Há uma ferramenta de dois scripts abaixo que recebe a pasta de um clipe e deixa uma Anim Sequence com o bake pronto no manequim, e ela lida com todos os três esqueletos sem nenhuma configuração, porque a contagem de articulações identifica qual deles você tem.
Do clipe para o arquivo, no seu computador
Python 3.8 puro ou mais recente. Sem Blender, sem pacotes. Indique ao script a pasta criada pelo Kimodo e você terá um .glb.
python kimodo_to_glb.py path/to/clip
python kimodo_to_glb.py clips/* --outdir glb
Ele verifica sua própria saída antes de gravar: ele reconstrói a pose a partir do arquivo que acabou de criar e a compara com a entrada, de modo que um eixo errado ou um quatérnio na ordem incorreta de componentes é detectado aqui, em vez de três etapas depois na Unreal. O número que ele exibe deve ficar por volta de 1e-08.
Do arquivo para o personagem, dentro da Unreal
Abra o Output Log, mude a caixa de entrada na parte inferior de Cmd para Python e cole:
py "C:/path/to/unreal_retarget.py" "C:/path/to/walk_150.glb"Isso importa o arquivo, cria o IK Rig e o IK Retargeter, aplica as duas correções abaixo, faz o bake e deixa uma Anim Sequence em /Game/Kimodo/Retargeted/. Coloque o manequim no seu nível, defina Animation Mode como Use Animation Asset e escolha a sequência. Passe vários caminhos para processá-los em lote ou informe o caminho de uma Skeletal Mesh por último para usar outro personagem como destino.
Ele gera um relatório para cada clipe em vez de deixar você avaliando no olho:
kick_120: SMPL-X, 22 joints
    9 chains mapped, 19 left at rest (Root, LeftThumb, ...)
    reach 102 cm to 95 cm, arms corrected by up to 48 deg
    arms match 0.998 (worst lowerarm_r), pelvis 93 cm, lowest toe -1 cm,
    travelled 123 cm over 4.0 s
arms match indica o quanto a direção dos braços do personagem se aproxima da direção dos braços do personagem de origem, medida em vários pontos do clipe. Acima de 0.95 é bom. lowest toe deve ficar perto de zero: muito acima e o personagem flutua, muito abaixo e ele afunda.
As poses de repouso não coincidem. O manequim fica em A-pose, o Kimodo não. Se deixar como está, o retargeter interpreta essa diferença como movimento e os braços ficam na posição errada durante o clipe inteiro. O script mede as duas poses e cancela a diferença em cada segmento do braço, começando pelo segmento pai e seguindo para o filho. Isso geralmente corresponde a algo entre 45 e 55 graus.
local_rotations_xyzw.f32 em [FRAMES, JOINTS, 4] e root_positions.f32 em [FRAMES, 3]. A tabela de formatos publicada indica 22 articulações, e isso é apenas para o SMPL-X. O SOMA tem 30 e o G1 tem 34.Um clipe do SOMA de 90 frames tem exatamente 90 x 30 x 4 x 4 = 43,200 bytes. Leia-o com um stride de 22 articulações e você não receberá nenhuma exceção, nenhum aviso, e sim uma animação que parece que o rig está tendo uma convulsão. Deduza a contagem de articulações a partir do tamanho do arquivo em vez de fixá-la no código.
Os dois scripts, um clipe de exemplo para você testar a parte da Unreal sem precisar gerar nada antes e as notas: a hierarquia completa de 30 articulações do SOMA com os índices das articulações pai, o mapeamento completo dos nomes do Mixamo, incluindo os ossos que não têm correspondência direta, a pegadinha da ordem dos quatérnios e o procedimento no Blender.
Resumo
| Etapa | Custo | Observações |
|---|---|---|
| Instalação da toolchain | ~30 min, ~3 GB | Build Tools, Vulkan SDK, Go |
| Compilação | ~2 min | Antes, duas correções de uma linha no código-fonte |
| Pesos | 15.2 GB + 1.13 GB cada | Encoder compartilhado entre todos os modelos |
| Geração com cache aquecido | ~20 s de processamento | Mais o streaming do disco, veja a seção 5 |
| Retarget para o Mixamo | Minutos | Mapeamento de nomes mais a correção da perna |
A grande novidade não é que existe um modelo de texto para movimento. É que este agora roda no hardware que você já tem, sob uma licença que permite lançar o resultado, e você consegue aplicar o movimento a um rig do Mixamo em uma tarde. O que mais me surpreendeu é que o gargalo é a leitura de disco, e não a placa de vídeo, o que significa que o upgrade mais barato para quem leva isso a sério é uma unidade NVMe, em vez de uma GPU melhor.
Se você quiser conhecer o restante do pipeline que leva até essa etapa, temos guias sobre o pipeline completo de personagens 3D com IA, rigging com IA para personagens não humanoides e HY-Motion, o outro modelo de texto para animação que vale a pena conhecer.