Stefan Vaskevich
Инструменты из этой статьи

Вы вводите «человек выполняет удар ногой с разворота» и получаете пригодную к работе анимацию прямо на своем компьютере — без окружения Python и без единого сетевого запроса. Это Kimodo — диффузионная модель генерации движений от NVIDIA, которую портировали на C++ и GGML, так что она работает на Vulkan или на обычном процессоре, требуя менее 2 GB памяти.
Я потратил день, устанавливая ее с нуля на Windows, генерируя клипы и перенося их на риги Mixamo и в Unreal Engine. В этом руководстве собрано все, что я узнал, включая две вещи, отнявшие у меня больше всего времени, о которых не написано ни в одном README: какие модели вообще разрешено использовать и почему вся система упирается в диск, а не в видеокарту.
1. Что такое Kimodo и что изменил порт на C++
NVIDIA выпустила Kimodo в марте 2026 года. Это кинематическая диффузионная модель движения, обученная на 700 часах коммерчески лицензированного оптического захвата движения; она превращает текстовые промпты и разреженные кинематические ограничения в 3D-движения человека и робота-гуманоида. Она поддерживает три формата скелета: собственное параметрическое тело SOMA от NVIDIA, робота-гуманоида Unitree G1 и SMPL-X.
Оригинальный релиз — это проект на PyTorch. Вам требовалось развернуть весь стек CUDA еще до того, как вы могли сгенерировать хотя бы один клип, а это серьезное препятствие для любого, чья машина настроена под работу с 3D, а не под машинное обучение.
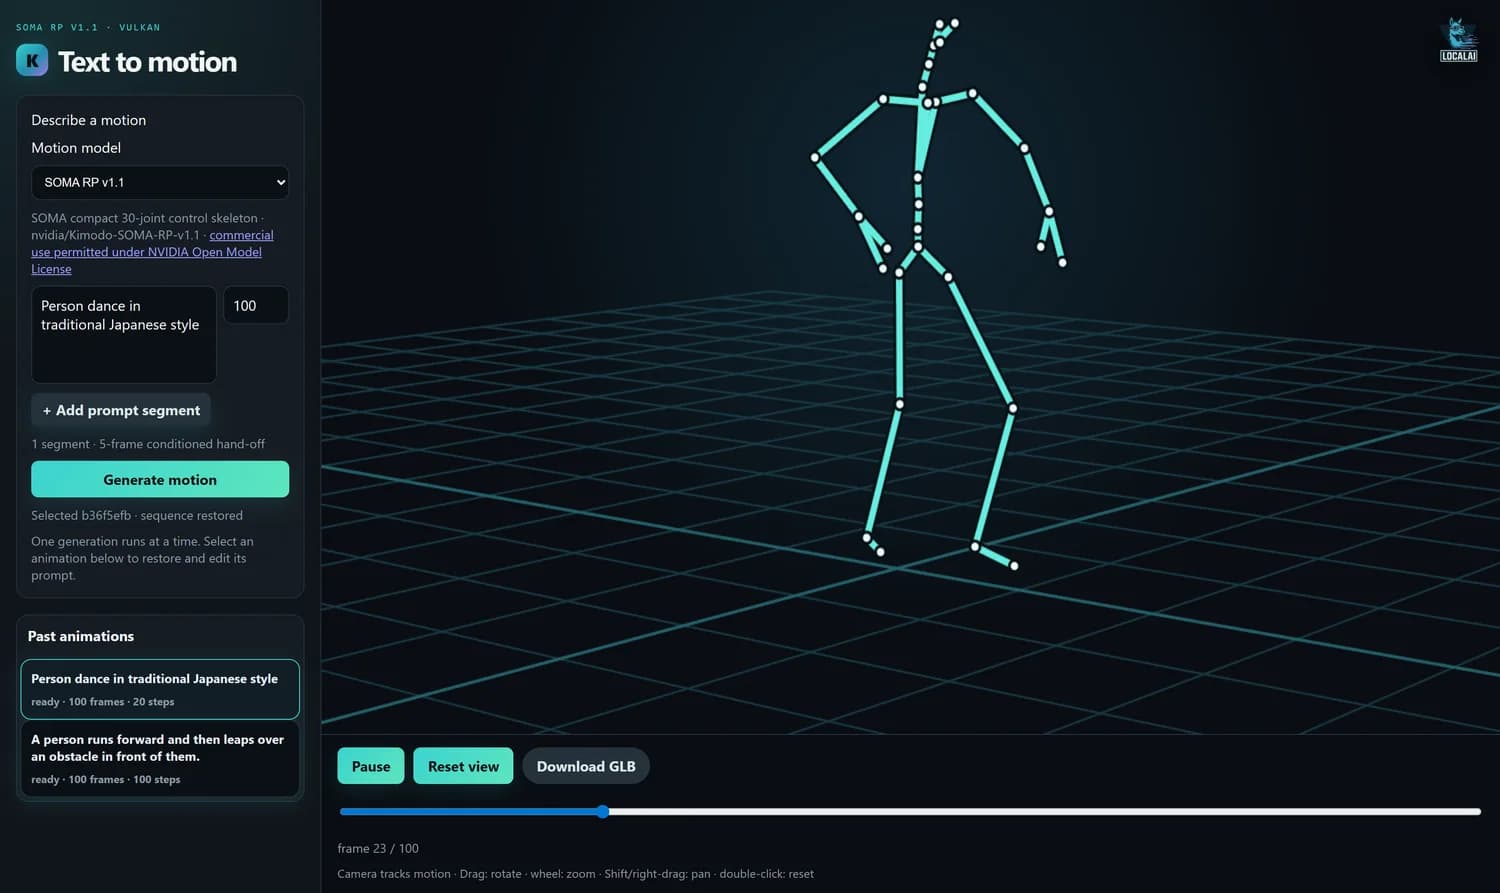
kimodo.cpp — это нативный порт на C++ и GGML. Он загружает веса GGUF, работает на Vulkan или на процессоре и поставляется с небольшим локальным веб-интерфейсом. Никакого Python при генерации, никакой CUDA, никакой сети. Вот и вся история, и это куда важнее, чем кажется, потому что переводит Kimodo из категории «то, что запускают специалисты по ML» в «то, что просто открывается на вашей рабочей станции».
2. Что изменилось с лицензиями 26 августа
Именно в этой части большинство статей ошибается, поскольку ситуация изменилась недавно и сразу в двух направлениях.
Изначально порт поставлялся с конвертированными весами SMPL-X. Их отозвали. Автор заметил, что апстрим-лицензия NVIDIA на этот конкретный чекпоинт прямо запрещает распространение производных моделей, и удалил GGUF, манифест и контрольные суммы. Карточка модели, появившаяся на их месте, прямо говорит об этом, а не оставляет после себя загадочную ошибку 404, что я оценил сильнее, чем ожидал.
Практически в тот же момент под совершенно другой лицензией появились четыре других чекпоинта, и их поддержка была добавлена в порт.
| Модель | Скелет | Лицензия | Коммерческое использование |
|---|---|---|---|
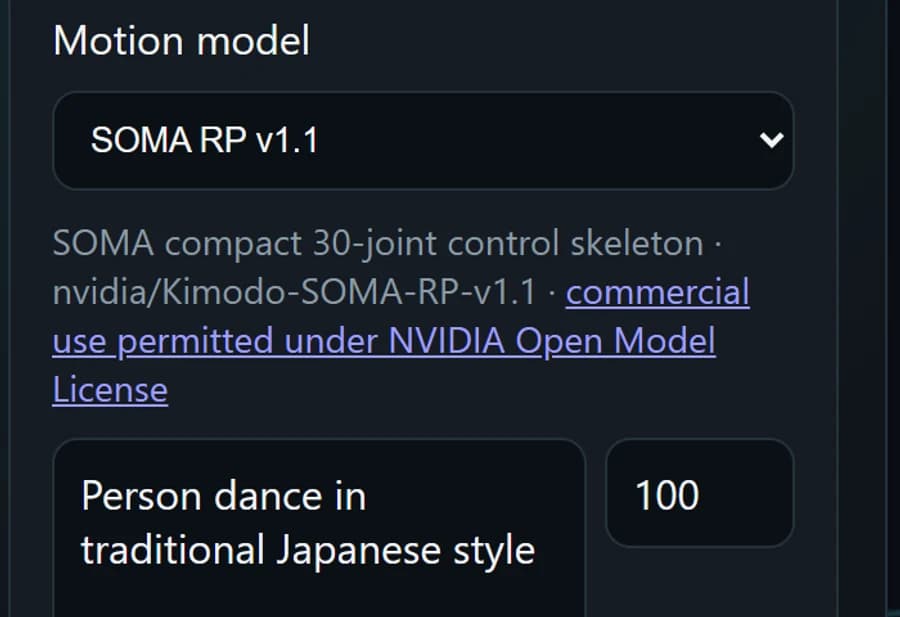
| SOMA RP v1.1 | SOMA, 30 суставов | NVIDIA Open Model | Разрешено |
| SOMA SEED v1.1 | SOMA, 30 суставов | NVIDIA Open Model | Разрешено |
| G1 RP v1 | Unitree G1, 34 сустава | NVIDIA Open Model | Разрешено |
| G1 SEED v1 | Unitree G1, 34 сустава | NVIDIA Open Model | Разрешено |
| SMPL-X RP v1 | SMPL-X, 22 сустава | NVIDIA Internal Scientific R&D | Только для исследований |
Интерфейс честно сообщает об этом, чего я не ожидал от порта, сделанного за выходные. Выберите модель, и он покажет, под какой лицензией вы работаете, еще до начала генерации.
3. Какое железо вам действительно нужно
Требования невысокие, но стоит разобраться, за счёт чего, а не просто посмотреть на таблицу.
| Ресурс | Минимум | Комфортно |
|---|---|---|
| Свободное место на диске | 25 GB | 35 GB на накопителе NVMe |
| Системная оперативная память | 4 GB | 32 GB; см. раздел 5 |
| VRAM, режим GPU | 1.2 GB | 2 GB |
| CPU | 2 ядра | 6 ядер |
Пиковое потребление памяти остаётся ниже 2 GB в любой конфигурации, на GPU или на процессоре. Нужный параметр — KIMODO_TEXT_LAYER_CHUNK; он задаёт число слоёв, а не гигабайтов: chunk 2 требует 1.2 GB VRAM, chunk 4 — 1.8 GB, а значение по умолчанию chunk 8 — 3.5 GB. Его увеличение ничего не ускоряет, потому что энкодер считывается один раз за запуск при любом размере чанка.
Есть жёсткий нижний предел около 1.3 GB. Таблица эмбеддингов представляет собой единый блок на 1.05 GB, который нельзя разделить ни при каком размере чанка, поэтому ниже этого значения программа вообще не сможет запуститься.
4. Установка на Windows
В документации проекта описан Linux. На Windows проект работает, и в файле CMake есть отдельная ветка для MSVC, но есть четыре момента, на которых можно потерять час. Вот краткая версия, а полное руководство доступно для скачивания в конце этого раздела.
Установите тулчейн, затем откройте новый терминал
Git, Visual Studio Build Tools с набором компонентов для разработки на C++, Vulkan SDK, а также Go, если вам нужен веб-интерфейс.
winget install Git.Git
winget install Microsoft.VisualStudio.2022.BuildTools --override "--quiet --wait --norestart --add Microsoft.VisualStudio.Workload.VCTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --includeRecommended"
winget install KhronosGroup.VulkanSDK
winget install GoLang.Go
Компонент VC.CMake.Project обязателен. Без него вы получите компилятор, но останетесь без CMake и Ninja, причём в тексте ошибки об этом не будет ни слова. Затем закройте все терминалы: установщик Vulkan задаёт переменную VULKAN_SDK для всей системы, и уже открытый терминал её никогда не увидит.
Клонируйте с подмодулями
git clone --recurse-submodules https://github.com/localai-org/kimodo.cpp
cd kimodo.cpp
GGML — это подмодуль. Обычное клонирование оставит его пустым, а скачивание репозитория в виде ZIP не сработает вовсе по той же причине.
Внесите два исправления в исходный код и соберите проект
Добавьте #include <stdexcept> в src/denoiser.cpp, src/generate.cpp и src/llm_tokenizer.cpp, а также замените path.c_str() на path.string().c_str() в src/llm_text_encoder.cpp. Обе правки корректны для любой платформы и просто ещё не влиты в основной репозиторий. Затем из терминала, где был запущен vcvars64.bat:
cmake -S . -B build-win -G Ninja -DCMAKE_BUILD_TYPE=Release -DKIMODO_ENABLE_VULKAN=ON -DKIMODO_BUILD_TESTS=OFF
cmake --build build-winСкачайте веса
Текстовый энкодер общий для всех моделей, поэтому его достаточно скачать один раз; он занимает 15.2 GB. Каждая модель движения добавляет к этому всего около 1.13 GB.
pip install huggingface_hub
hf download LocalAI-io/Llama-3-Kimodo-GGML --local-dir . --include "generated/llm2vec-text-bundle/*"
hf download LocalAI-io/Kimodo-SOMA-RP-v1.1-GGML --local-dir . --include "models/*"
Добавление всех четырёх моделей с открытой лицензией потребует около 4.5 GB, а не четыре раза по 17, так как энкодер у них общий.
hf download с параметром --include ничего не находит и успешно завершает работу. Ни ошибки, ни файлов, код завершения ноль. Мой скрипт установки отчитался об успешном выполнении, и пропажу модели я заметил, только когда генерация завершилась сбоем. Всегда проверяйте, что файл .gguf действительно оказался в models\.Все команды, оба исправления исходного кода с точным описанием ошибок, которые они предотвращают, все переменные окружения и таблица, которая поможет найти причину каждой проблемы. Я написал руководство после настройки на машине, где вообще не было компилятора.
kimodo-windows-setup.md5. Генерация первого клипа
Аргументы командной строки позиционные, а библиотеки DLL для GGML находятся в папке bin в дереве сборки, а не рядом с исполняемым файлом. Упустите это — и программа мгновенно закроется без какого-либо вывода: со стороны это выглядит как краш, но на самом деле Windows просто не смогла загрузить DLL.
set PATH=%CD%\build-win\bin;%PATH%
build-win\kmd-generate.exe models\kimodo-soma-rp-v1.1-f32.gguf generated\llm2vec-text-bundle prompt.txt 90 20 41 out
Это 90 кадров при 30 fps, то есть три секунды, с 20 шагами денойзинга и сидом 41. А если вы хотите использовать веб-интерфейс:
go run ./demo -addr 127.0.0.1:8094 -generator build-win/kmd-generate.exeКачество результата зависит от двух чисел. При значении Frames примерно до 300 кадров, или десяти секунд, движение остаётся связным. При 400 кадрах в клипе появляется дрожание, а при 600 он скатывается в шум примерно после 300-го кадра. Как ни странно, более короткие клипы получаются бодрее: один и тот же промпт на 120 кадрах воспринимается чётче и атлетичнее, чем на 300, потому что модель заполняет лишнее время, а не выполняет действие с большей отдачей.
Steps — это количество шагов денойзинга, и 20 подходит как для черновых тестов, так и для финальных вариантов. Затраты здесь линейные, так что 100 шагов обойдутся в пять раз дороже без какого-либо видимого выигрыша. В комплектном интерфейсе в demo/index.html сейчас жёстко зашито значение 100, и его стоит поменять на 20, прежде чем делать что-то серьёзное.
На моей машине с Ryzen 7 7800X3D, 31 GB оперативной памяти и весами на SATA SSD трёхсекундный клип занял 399 секунд. Из них примерно 380 секунд заняло чтение с диска и 10 секунд ушло на CPU. Видеокарта RTX 4070 SUPER всё это время простаивала. Накопитель выдавал 40 MB/s, а 15.2 GB при 40 MB/s — это 380 секунд. Арифметика сходится идеально.
Два решения в порядке эффективности: перенесите веса на накопитель NVMe и освободите оперативную память перед генерацией. Энкодеру требуется около 16 GB свободного файлового кэша, чтобы оставаться в памяти, а на машине с 32 GB при открытом браузере и чате доступно лишь около 7 GB, поэтому она ведёт себя как машина с 16 GB.
6. Перенос движения на реальный риг
Генерация — простая половина задачи. Этот порт интересен 3D-художнику, а не исследователю, именно тем, что полученное движение можно перенести на обычный риг персонажа почти без проблем.
В веб-интерфейсе есть кнопка Download GLB. Демо-сервер сам собирает glTF, так что вы получаете файл, который открывается в Blender с уже готовой иерархией костей и ключевыми кадрами. Для большинства задач этого вполне достаточно, и это позволяет опустить все технические подробности о форматах ниже.
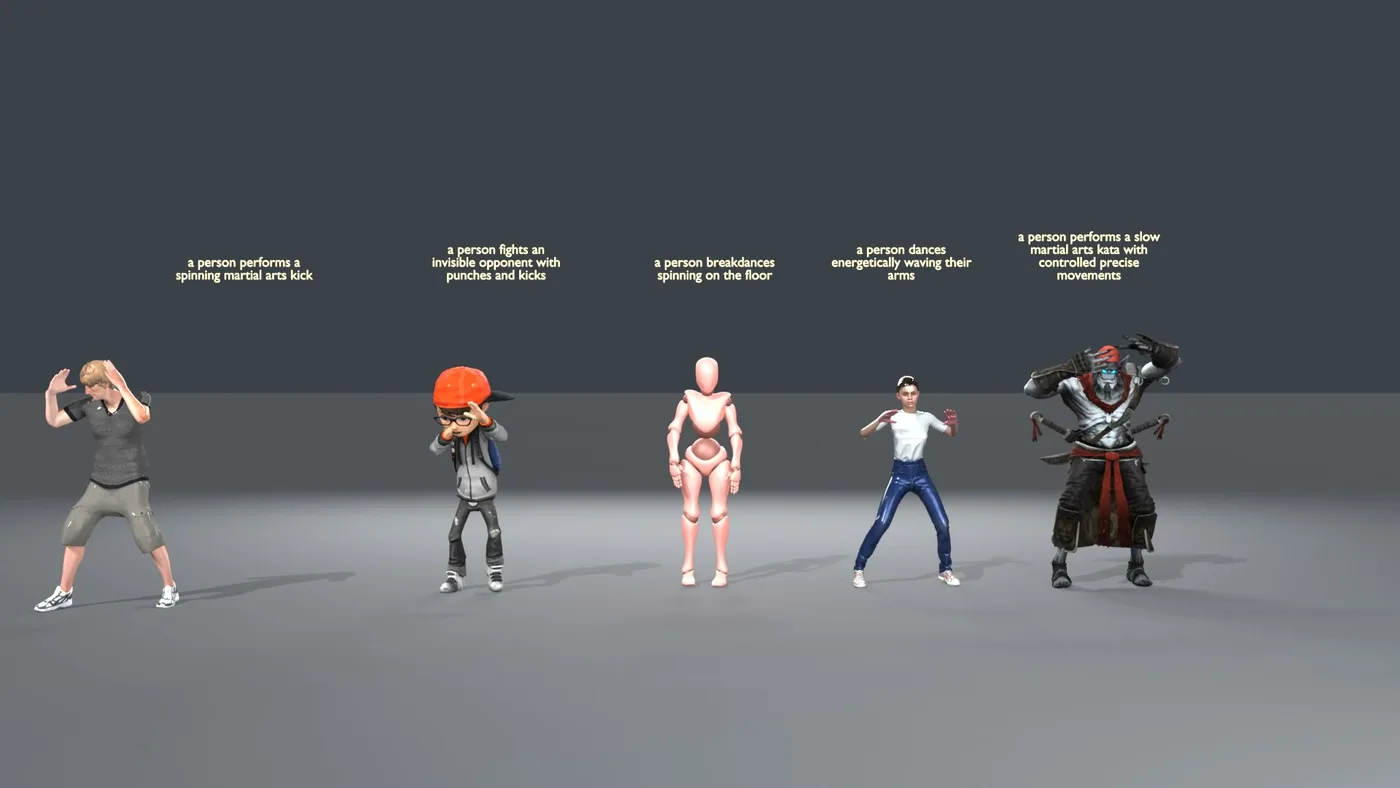
И вот здесь SOMA оказывается настоящей удачей. В ней вообще не используется соглашение об именовании SMPL-X. Ее 30 суставов названы Hips, Spine1, LeftShoulder, LeftForeArm и так далее, что практически в точности совпадает со стандартами Mixamo. Большинство костей сопоставляются простым добавлением префикса mixamorig: — и больше ничего не нужно.
LeftLeg у SOMA — это бедро. У Mixamo mixamorig:LeftLeg — это голень. Правильное сопоставление: LeftLeg из SOMA в mixamorig:LeftUpLeg, а LeftShin из SOMA — в mixamorig:LeftLeg. Сопоставление только по префиксу даст персонажа, у которого колени сгибаются прямо от бедра, и это первое, что стоит проверить, если перенос выглядит неправильно.Для Unreal я перестал делать это вручную. Ниже есть инструмент из двух скриптов: он берет папку с клипом и выдает запеченный Anim Sequence на манекене, причем без какой-либо настройки обрабатывает все три скелета, определяя нужный по количеству суставов.
Как превратить клип в файл на компьютере
Только Python 3.8 или новее. Без Blender и сторонних пакетов. Укажите папку, созданную Kimodo, и вы получите файл .glb.
python kimodo_to_glb.py path/to/clip
python kimodo_to_glb.py clips/* --outdir glb
Скрипт проверяет собственный результат перед записью: он восстанавливает позу из только что созданного файла и сравнивает ее со входными данными, так что неверная ось или кватернион с перепутанным порядком компонентов обнаруживаются сразу, а не спустя несколько шагов в Unreal. Число, которое он выводит, должно быть около 1e-08.
Как перенести движение из файла на персонажа в Unreal
Откройте Output Log, переключите поле ввода внизу с Cmd на Python и вставьте:
py "C:/path/to/unreal_retarget.py" "C:/path/to/walk_150.glb"Скрипт импортирует файл, создает IK Rig и IK Retargeter, применяет две описанные ниже коррекции, запекает анимацию и сохраняет Anim Sequence по пути /Game/Kimodo/Retargeted/. Перетащите манекен на уровень, установите для Animation Mode значение Use Animation Asset и выберите полученную анимацию. Чтобы обработать файлы пакетом, передайте несколько путей, а если хотите применить движение к другому персонажу — укажите путь к Skeletal Mesh последним.
Скрипт выводит отчет по каждому клипу, избавляя от необходимости оценивать результат на глаз:
kick_120: SMPL-X, 22 joints
    9 chains mapped, 19 left at rest (Root, LeftThumb, ...)
    reach 102 cm to 95 cm, arms corrected by up to 48 deg
    arms match 0.998 (worst lowerarm_r), pelvis 93 cm, lowest toe -1 cm,
    travelled 123 cm over 4.0 s
arms match показывает, насколько точно руки персонажа направлены туда же, куда были направлены руки источника, по выборке кадров из клипа. Значение выше 0.95 — хороший результат. Параметр lowest toe должен быть близок к нулю: если значение заметно выше, персонаж висит в воздухе, если заметно ниже — проваливается под пол.
Позы покоя не совпадают. Манекен в состоянии покоя стоит в A-pose, а Kimodo — нет. Если оставить все как есть, ретаргетер посчитает эту разницу движением, и руки будут стоять криво на протяжении всего клипа. Скрипт измеряет обе позы и компенсирует расхождение для каждого сегмента руки — от родительского к дочернему. Обычно величина поправки составляет от 45 до 55 градусов.
local_rotations_xyzw.f32 с размерностью [FRAMES, JOINTS, 4] и root_positions.f32 с размерностью [FRAMES, 3]. В опубликованной таблице форматов указано 22 сустава, но это относится только к SMPL-X. У SOMA их 30, а у G1 — 34.Клип SOMA на 90 кадров весит ровно 90 x 30 x 4 x 4 = 43,200 байт. Если прочитать его с шагом в 22 сустава, вы не получите ни исключений, ни предупреждений, а лишь анимацию, в которой риг будто бьется в судорогах. Вычисляйте количество суставов из размера файла, а не зашивайте его жестко в код.
Оба скрипта, пример клипа, чтобы вы могли протестировать часть для Unreal без предварительной генерации, и заметки: полная иерархия SOMA из 30 суставов с индексами родителей, полная карта имен Mixamo, включая кости без прямого соответствия, подвох с порядком компонентов кватерниона и инструкция для Blender.
Итоги
| Этап | Затраты | Примечания |
|---|---|---|
| Установка тулчейна | ~30 min, ~3 GB | Build Tools, Vulkan SDK, Go |
| Сборка | ~2 min | Сначала две однострочные правки в исходном коде |
| Веса | 15.2 GB + по 1.13 GB на модель | Энкодер общий для всех моделей |
| Генерация после прогрева | ~20 s вычислений | Плюс потоковое чтение с диска, см. раздел 5 |
| Ретаргетинг на Mixamo | Несколько минут | Сопоставление имен плюс исправление для ног |
Главная новость не в том, что существует модель text-to-motion. А в том, что теперь она работает на железе, которое у вас уже есть, и распространяется под лицензией, позволяющей выпускать готовый результат, а созданное движение можно перенести на риг Mixamo за полдня. Больше всего меня удивило то, что узким местом оказывается чтение с диска, а не видеокарта, а значит, самый дешевый апгрейд для любого, кто занимается этим серьезно, — накопитель NVMe, а не более мощный GPU.
Если вам нужны руководства по остальным этапам пайплайна, у нас есть материалы о полном пайплайне создания 3D-персонажей с помощью ИИ, ИИ-риггинге негуманоидных персонажей и HY-Motion — еще одной модели text-to-animation, о которой стоит знать.