Stefan Vaskevich
Ferramentas usadas neste artigo


Qual modelo de IA é o melhor para o Blender e 3D no momento? Para a maioria dos trabalhos, Claude Opus 5.5. Ele venceu o meu teste de jogo completo contra o GPT-6.1, o Gemini 4 e o Muse da Meta, e superou o Gemini 4 e o Kimi K3.1 Pro em quase todas as tarefas no Blender. GPT-6 Astra é a escolha para carros e navios procedurais detalhados, e os constrói de forma mais rápida ou mais barata. Gemini 4 Argon é a opção econômica, muitas vezes por um décimo do preço por tarefa. Nenhum deles consegue fazer a abertura de UV de um modelo ainda.
Esta página reúne sete dos meus vídeos de comparação de agosto a novembro de 2026: mais de 40 testes em que cada modelo recebeu o mesmo prompt, as mesmas ferramentas e esforço máximo. Abaixo você encontra o vencedor de cada tipo de trabalho em 3D, os resultados dos confrontos diretos e quanto custou cada execução. Os custos correspondem ao que esses mesmos tokens custariam pela API; rodei a maioria dos testes por assinaturas. Atualizo esta página quando um novo modelo é lançado.
O teste mais recente: quatro modelos criam o Fortnite na Unity
Props, mapa e um jogo completo, com cada resultado e cada conta na tela.
1. O melhor modelo de IA para cada trabalho 3D
Nenhum modelo ganha em tudo, então aqui está a resposta para cada tipo de trabalho. “Segundo lugar” é o modelo ao qual eu recorreria se a escolha for cara demais ou não estiver disponível para você.
| Trabalho | Escolha | Segundo lugar | Por quê |
|---|---|---|---|
| Um jogo completo na Unity | Claude Opus 5.5 | Gemini 4 Argon | A única build cuja jogabilidade correspondia ao que o briefing pedia; também a mais rápida das quatro (24 h de tempo de agente) |
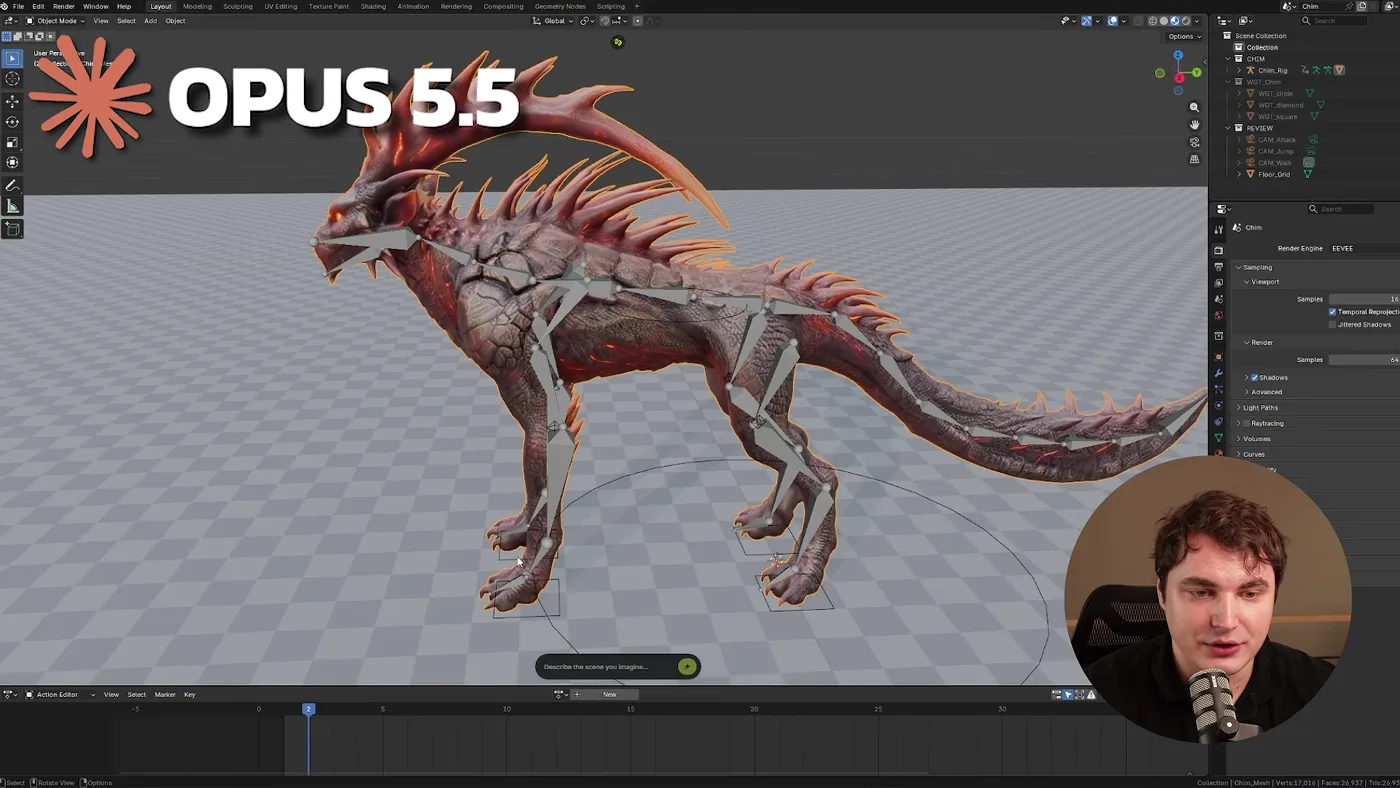
| Animação de criaturas e personagens | Claude Opus 5.5 | GPT-6 Astra | Mesma qualidade de rig, mas ciclos de pulo e ataque claramente melhores, em 46 minutos contra 63 |
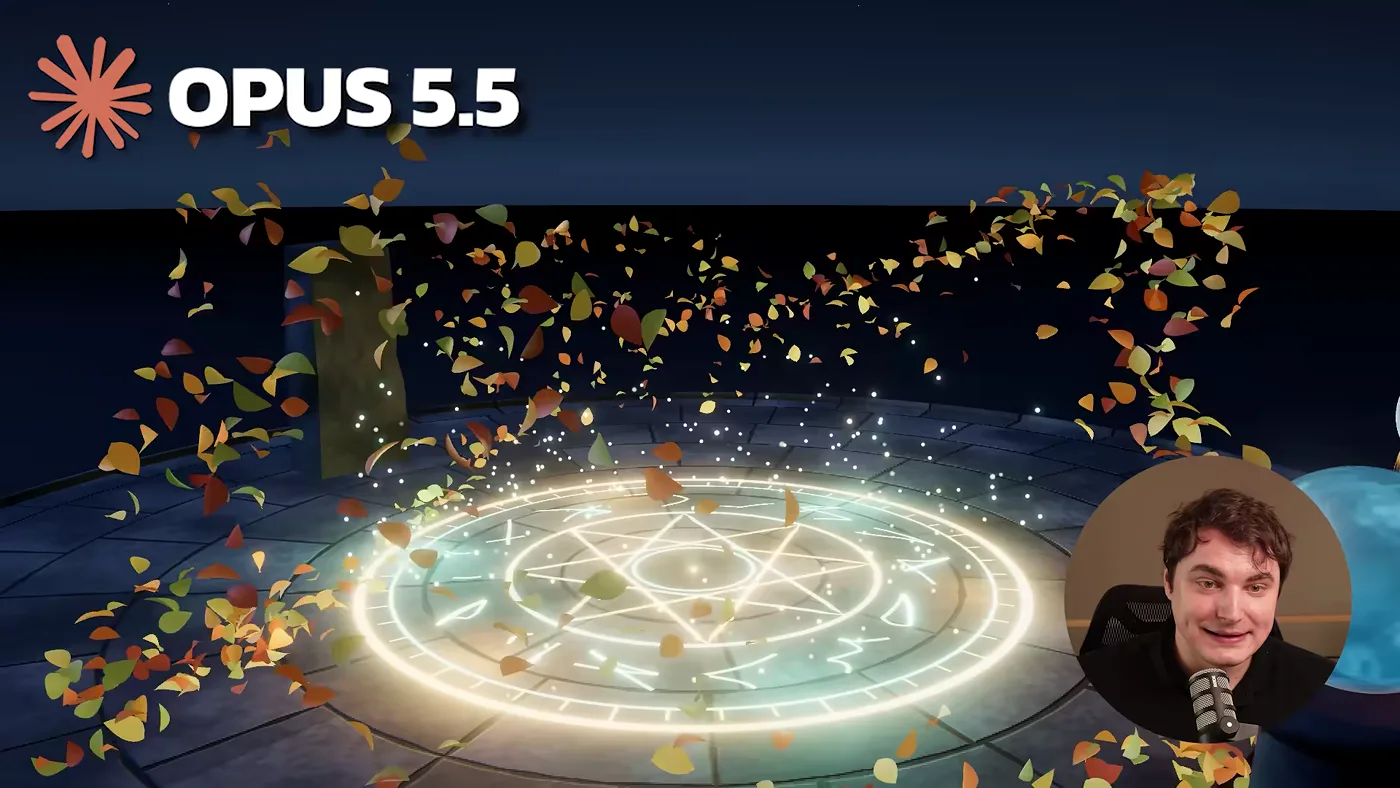
| VFX e shaders | Claude Opus 5.5 | GPT-6 Astra | O círculo mágico, o redemoinho de folhas e o trabalho de câmera estavam um nível acima |
| Hard-surface procedural: carros, navios | GPT-6 Astra | Claude Opus 5.5 | Mais detalhes no Cadillac e no galeão; o galeão por cerca de metade do custo |
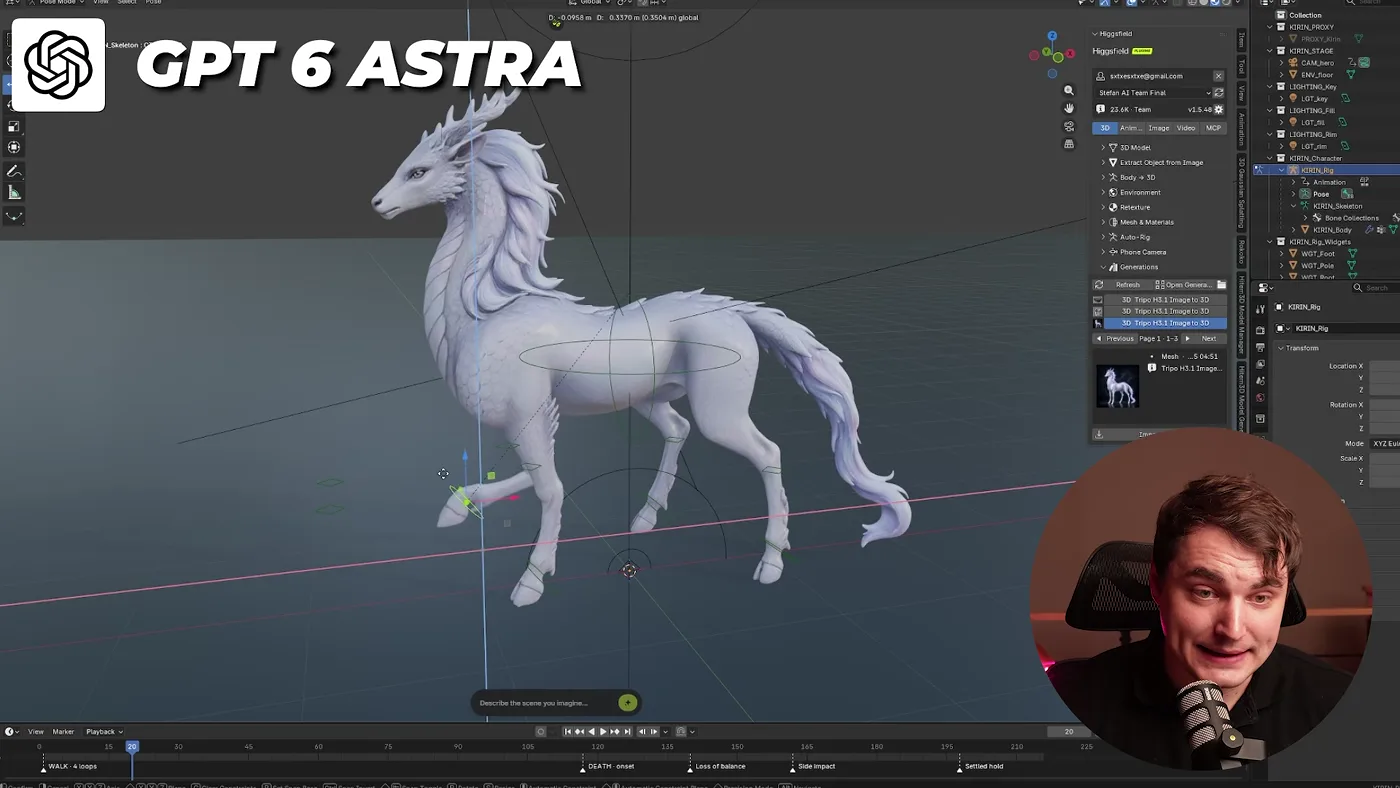
| Rigging de uma criatura | GPT-6 Astra ou Opus 5.5 | - | Ambos criam um rig de controle com IK; o GPT-6 Astra fez isso sem que ninguém pedisse |
| Props individuais com orçamento limitado | Gemini 4 Argon | GPT-6.1 Sol | Melhores props individuais no teste do Fortnite, muitas vezes por um décimo do preço do Opus; muito lento |
| Pesos abertos para você mesmo rodar | Kimi K3.1 Pro | DeepSeek 4.1 | Mais ou menos no nível do Gemini 4 nos meus testes, e superou o Gemini em vários deles |
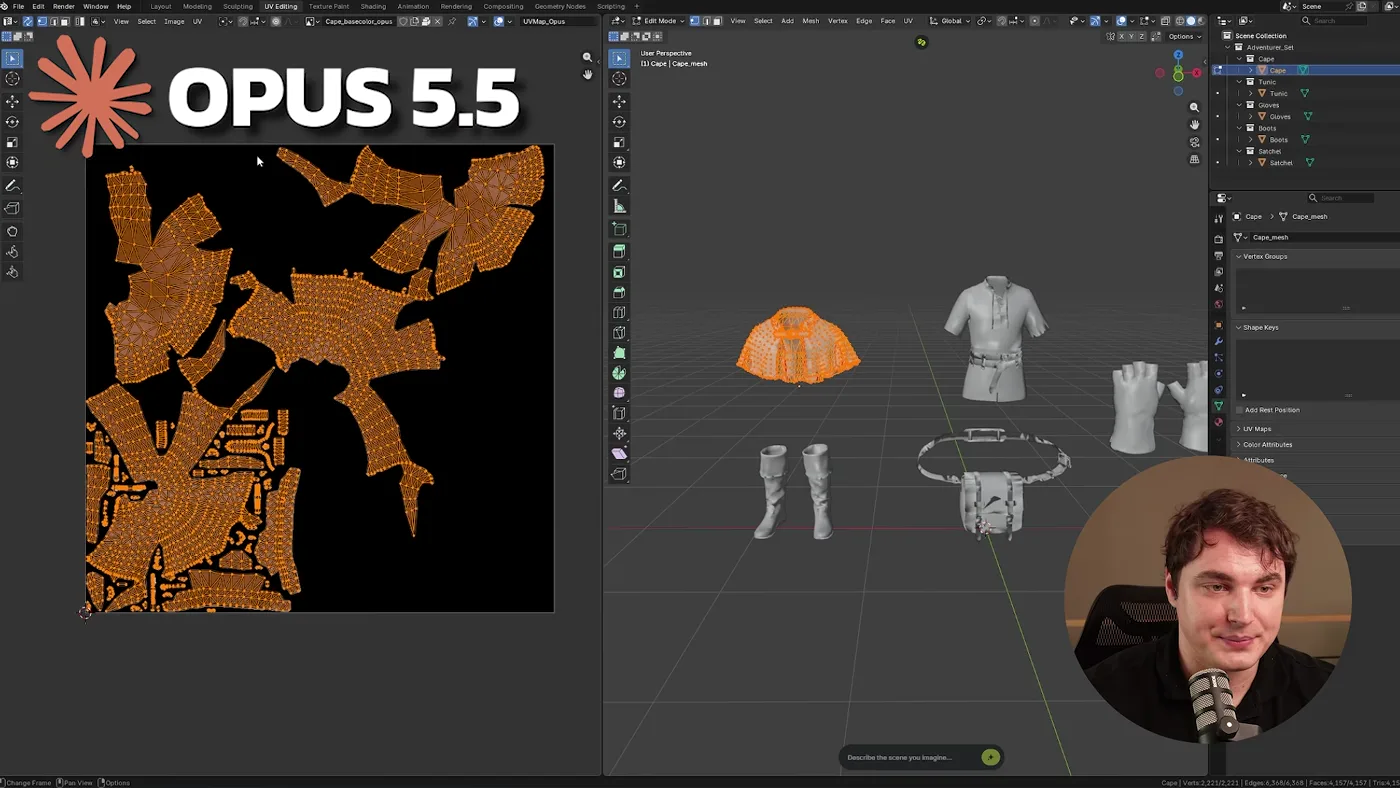
| Abertura de UV | Nenhum deles | - | Tanto o Opus 5.5 quanto o GPT-6 Astra falharam: ilhas minúsculas, metade do espaço UV desperdiçado |
Uma observação sobre os nomes, porque eles causam confusão. GPT-6 Astra é o modelo de ponta da OpenAI. GPT-6.1 Sol é a versão mais barata para o dia a dia que perdeu o teste do Fortnite; o resultado dele não diz nada sobre o Astra. Opus 5.5 é o segundo nível da Anthropic, abaixo do Fable, e em 3D bate de frente com o GPT-6 Astra de qualquer forma.
2. Claude Opus 5.5 vs GPT-6 Astra no Blender
Esses dois formam a disputa mais acirrada. Dei a ambos as mesmas dez tarefas com esforço máximo, cada um em seu próprio harness (Claude Code e Codex CLI), com acesso total ao Blender via MCP e permissão para chamar APIs de geração 2D e 3D pelo plugin do Higgsfield. Na maior parte do tempo, eles preferiram construir tudo de forma procedural mesmo assim.
| Teste | Vencedor | Tempo e custo |
|---|---|---|
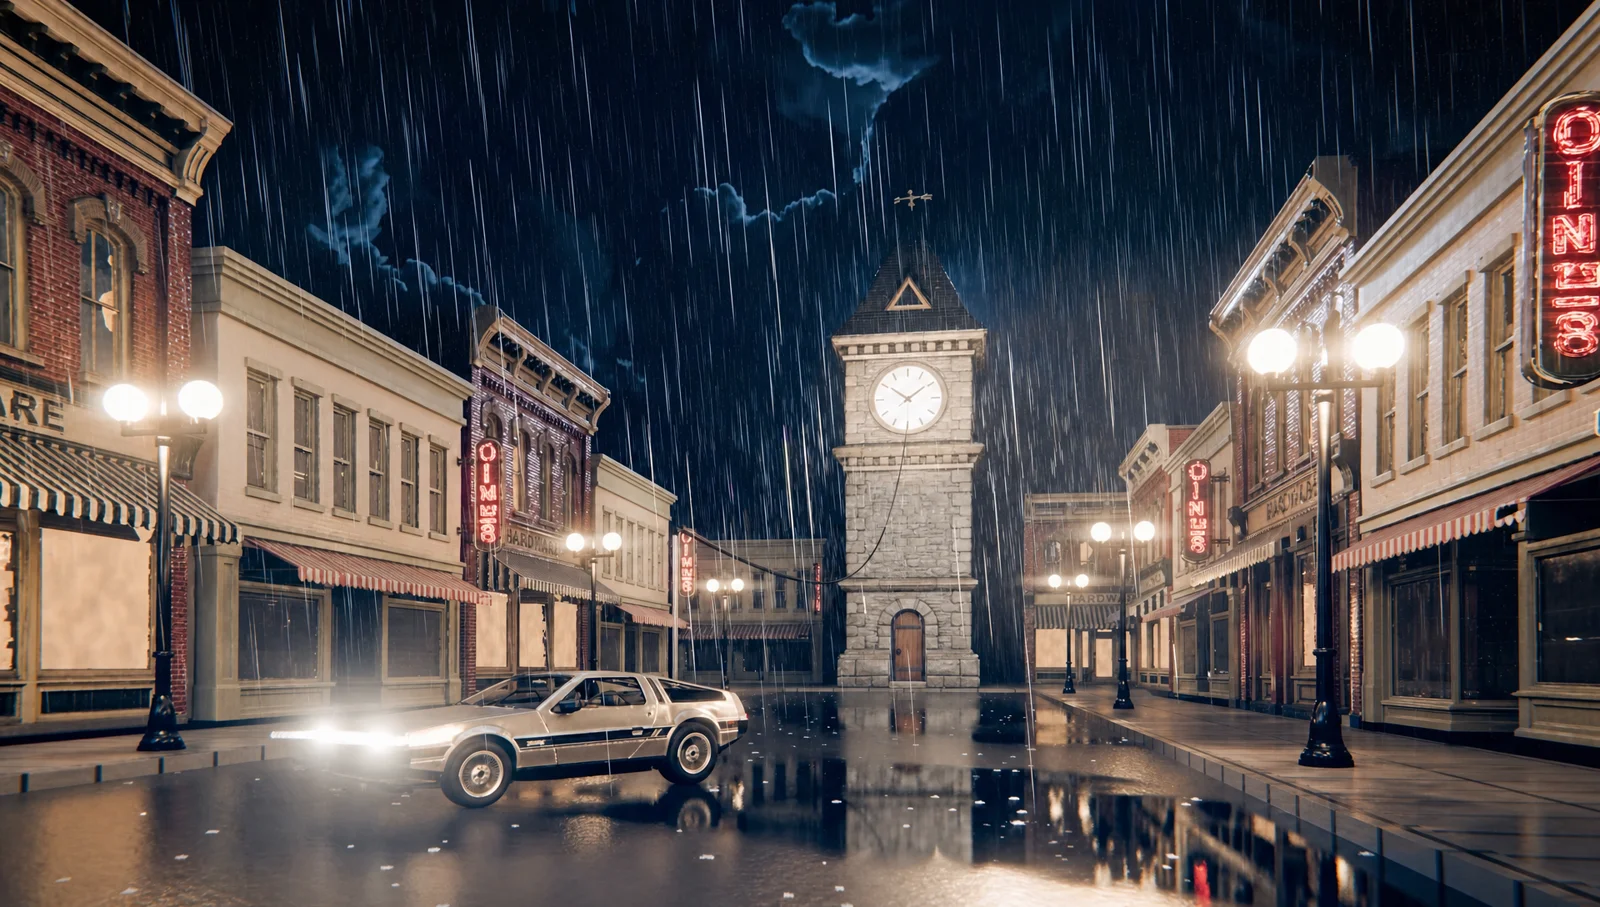
| Cena de rua de filme com um DeLorean | Opus 5.5 | Cerca de 1,5 h e cerca de $25 cada; o Opus adicionou os rastros de fogo |
| Notre-Dame, totalmente procedural | Empate | O GPT-6 Astra levou 42 minutos, o Opus 5.5 levou 96 |
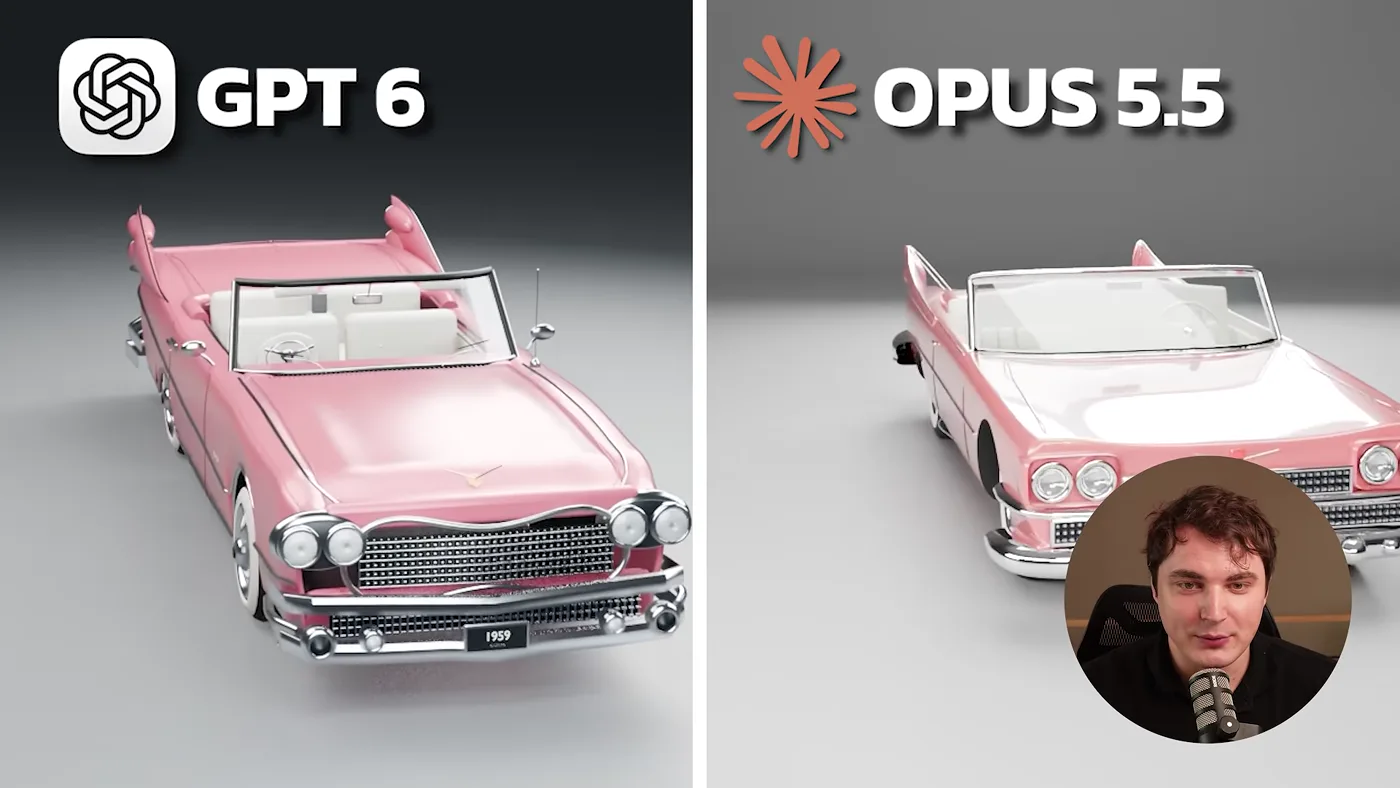
| Cadillac Eldorado, procedural | GPT-6 Astra | Mais detalhes e luzes melhores; mesmo tempo, custo similar |
| Galeão pirata, procedural | GPT-6 Astra | Cerca de 1 h cada; o GPT-6 Astra por cerca de metade do custo |
| Conjunto de VFX no Three.js | Opus 5.5 | Cerca de 30 minutos cada, poucos tokens |
| Abertura de UV de quatro assets | Ambos falharam | Cerca de 20 minutos e $10 cada |
| Caminhada, pulo e ataque de criatura | Opus 5.5 | 46 minutos contra 63 |
| Animação de humanoide de Lego | Opus 5.5, por pouco | Nenhum dos dois ficou tão divertido quanto eu esperava |
| Castelo com fogos de artifício e um timelapse | Resultado dividido | O GPT-6 criou o castelo mais detalhado; o Opus teve a melhor movimentação |
| Jogo em HTML com um único prompt | Opus 5.5 | Muito mais divertido de jogar, com quase o triplo de tempo e custo |
O placar: Opus 5.5 com cinco, GPT-6 Astra com dois, e três testes que terminaram em empate, resultado dividido ou falha compartilhada. O GPT-6 Astra vence quando o objeto pode ser descrito com matemática: cascos simétricos, frisos cromados, janelas repetitivas. O Opus 5.5 vence quando o resultado precisa se mover ou passar uma boa sensação, o que representa a maior parte do trabalho com jogos.
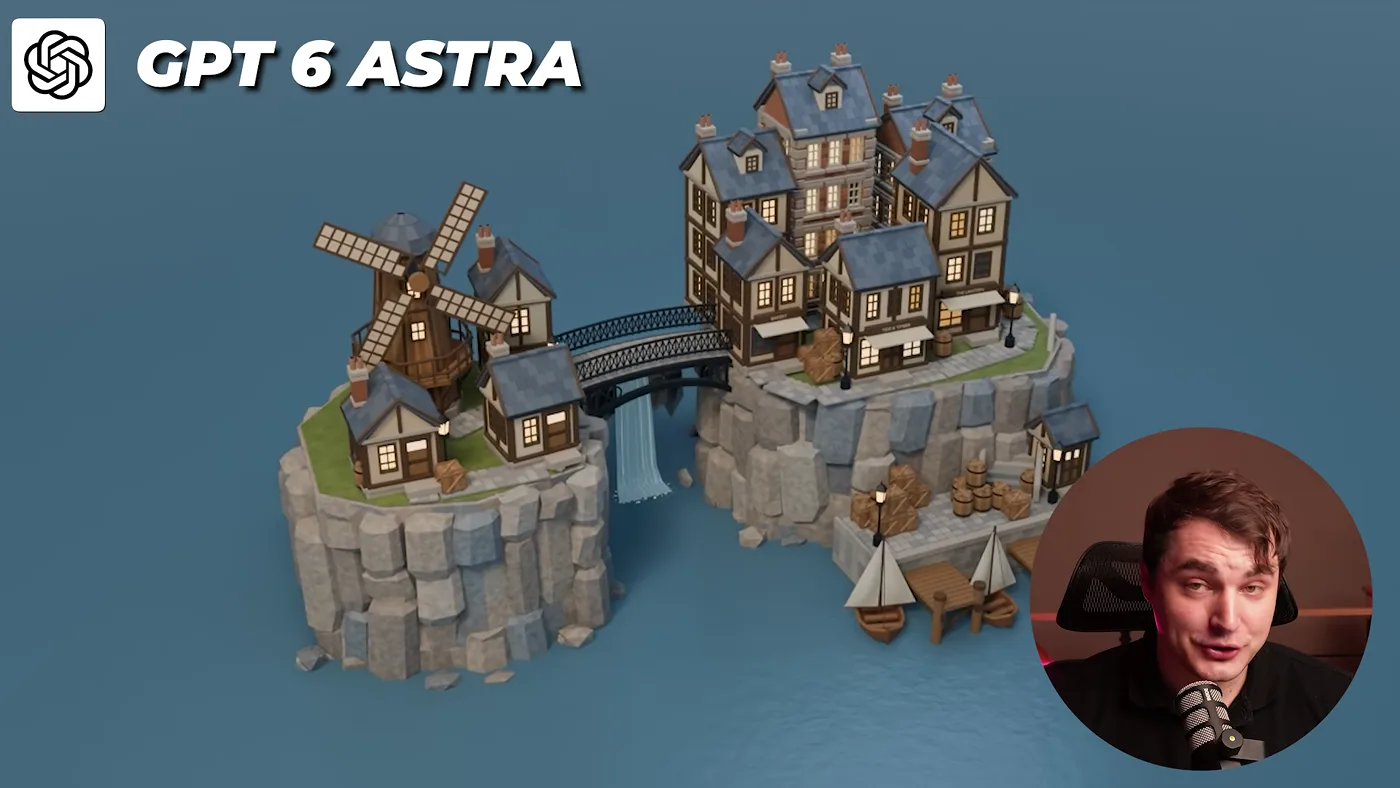
O GPT-6 Astra, por si só, ainda é o modelo que me fez repensar o trabalho em 3D em setembro. Contra o Fable 5.1, ele fez o rigging do meu quadrúpede com pesos limpos e adicionou um control rig com cinemática inversa que eu nunca tinha pedido. Ele reconstruiu uma cidade inteira a partir de uma única imagem de referência, de forma procedural, em cerca de uma hora, com cerca de 70K faces. Construiu um carro a partir de blueprints com uma animação de montagem e escreveu um add-on funcional para o Blender em um único prompt. Mais de dez desses testes consumiram cerca de 7% do meu limite semanal no plano mais alto do ChatGPT.
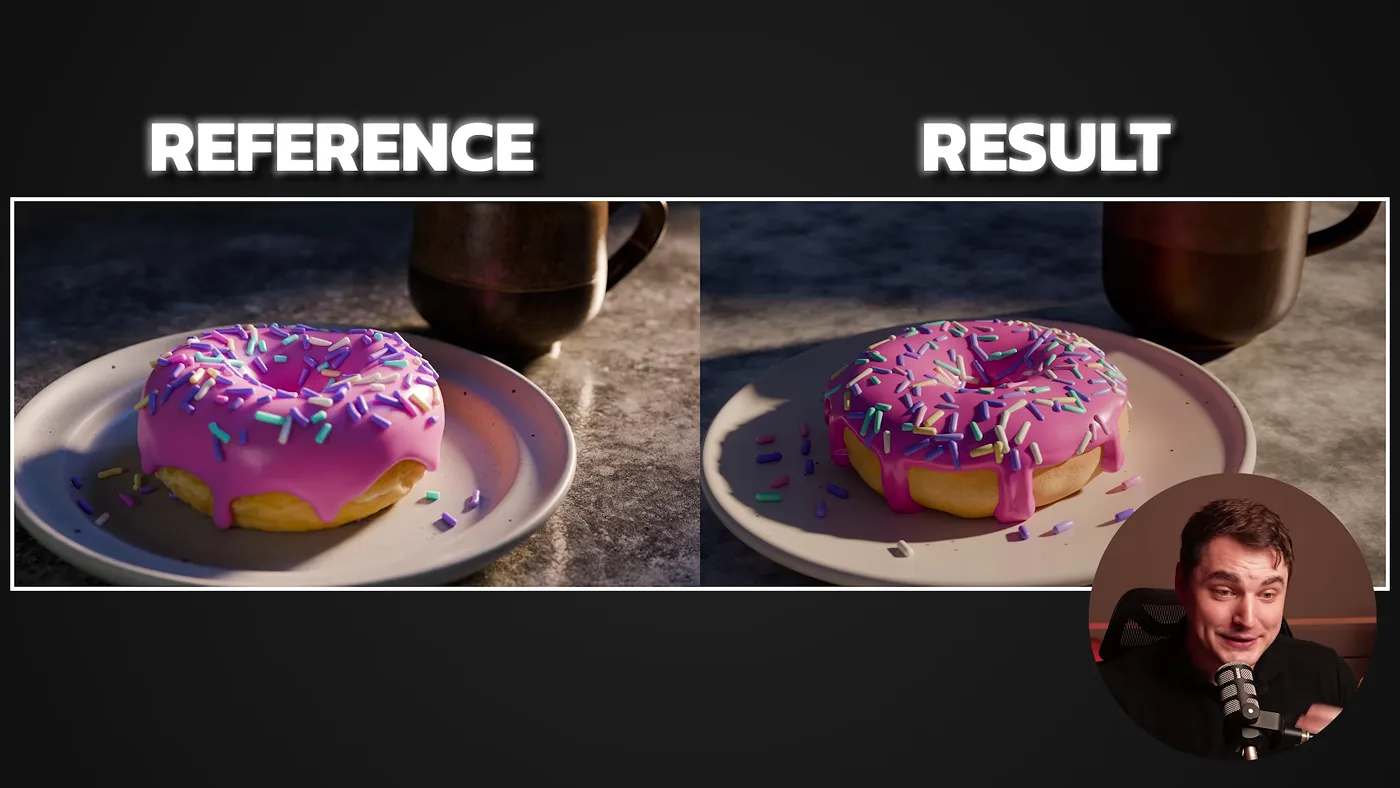
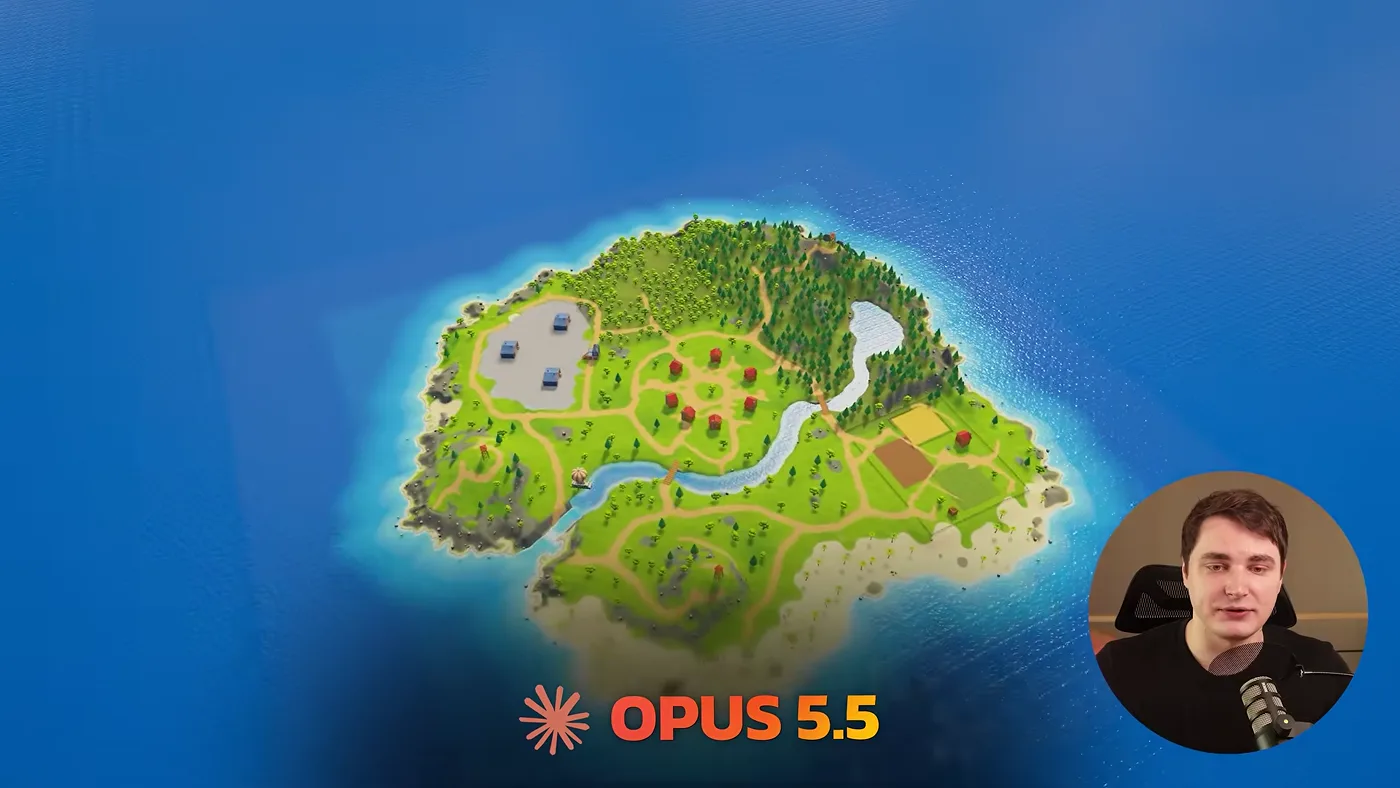
O Opus 5.5 conquistou seu espaço ao refazer testes com os quais os melhores modelos tinham dificuldade há um ano. Duas rodadas do famoso teste do donut levaram 100 minutos e custaram cerca de $21, e o resultado da rodada com imagem de referência ficou quase idêntico a ela. Uma animação de teclado levou 111 minutos e custou $23; uma ilha montada a partir de 13 modelos gerados no Tripo levou 62 minutos e custou cerca de $20, mais $5.50 em gerações; e um jogo de futebol jogável levou 23 minutos. Joguei essa versão por 20 minutos e quase não encontrei bugs.
3. Gemini 4 Argon: a escolha econômica, com limites
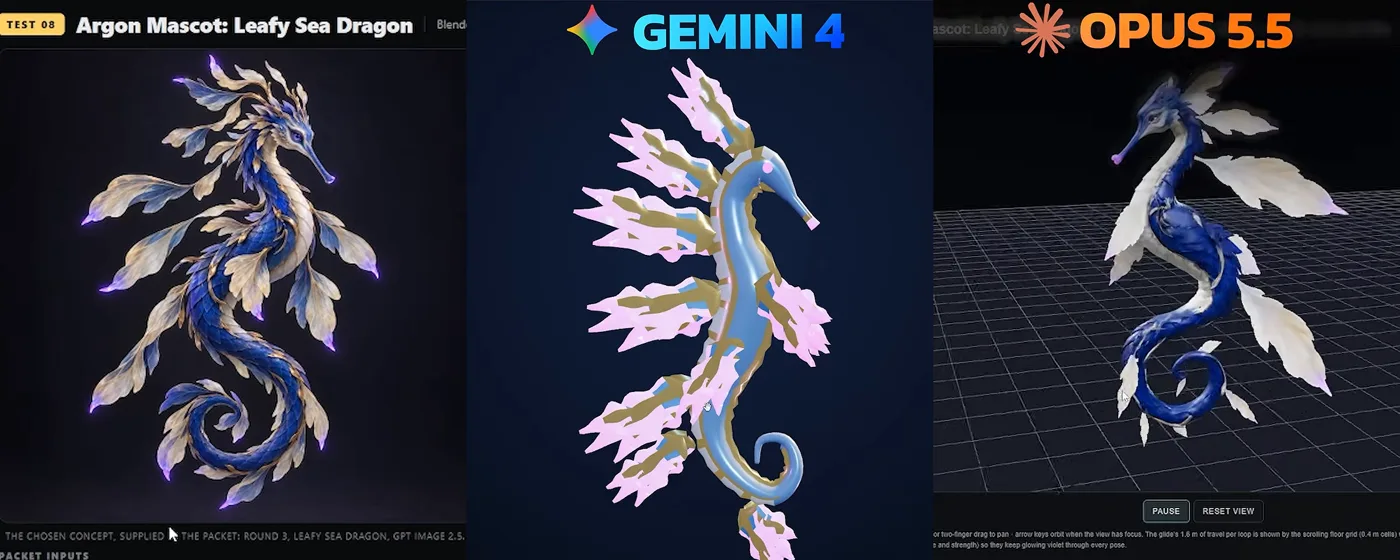
O Google prometeu muito para o Gemini 4 em 3D, e os benchmarks oficiais o colocam acima do GPT-6 Astra e do Opus 5.5 na maioria deles. Nos meus sete testes diretos contra o Opus 5.5, ele perdeu seis em qualidade, e o sétimo só foi a favor dele porque o Opus interpretou mal o meu prompt. Ele também custou de 4 a 14 vezes menos em todas as vezes: $2 contra $15 no dragão-marinho, $1.50 contra $21.35 em um clone realista de Minecraft.
- Mansão de vidro a partir de duas blueprints: ambos posicionaram tudo corretamente, o Opus ficou melhor e o Gemini custou um quarto do valor.
- Rig e animação de dragão-marinho: o Gemini falhou completamente, mesmo com acesso a um gerador 3D. O Opus gerou o corpo e as folhas e conectou tudo corretamente.
- Papel de parede de aquário, VFX de incenso e clones de Rocket League e Minecraft: Opus em todas as vezes, por cerca de 7 a 14 vezes o preço.
- Cena de menu de jogo: o Gemini entregou uma página funcional em 30 minutos por $2; o Opus interpretou mal o meu prompt e criou um arquivo do Blender no lugar.
Depois, o teste do Fortnite mudou parte desse cenário. Construindo props um de cada vez, o Gemini 4 fez os melhores modelos individuais entre os quatro e terminou em segundo no geral, com o melhor feedback de impacto e a melhor destruição. O preço foi a demora: ele trabalhou nos props por quase 14 horas, enquanto o Opus terminou o mesmo conjunto em cerca de 4.
4. Um jogo completo: Opus 5.5 vs GPT-6.1 vs Gemini 4 vs Muse
É na criação de um jogo inteiro que os modelos desmoronam. Pedi a quatro modelos para recriar o Fortnite no Unity em três etapas: um conjunto de props, o mapa e depois o jogo completo. Usei os mesmos prompts, Blender e o Unity CLI como ferramentas e Mixamo para personagens e animação. Não usei nenhum gerador 2D ou 3D, para que os modelos tivessem que fazer o trabalho sozinhos. Prompts adicionais foram permitidos; o teste inteiro levou três dias.
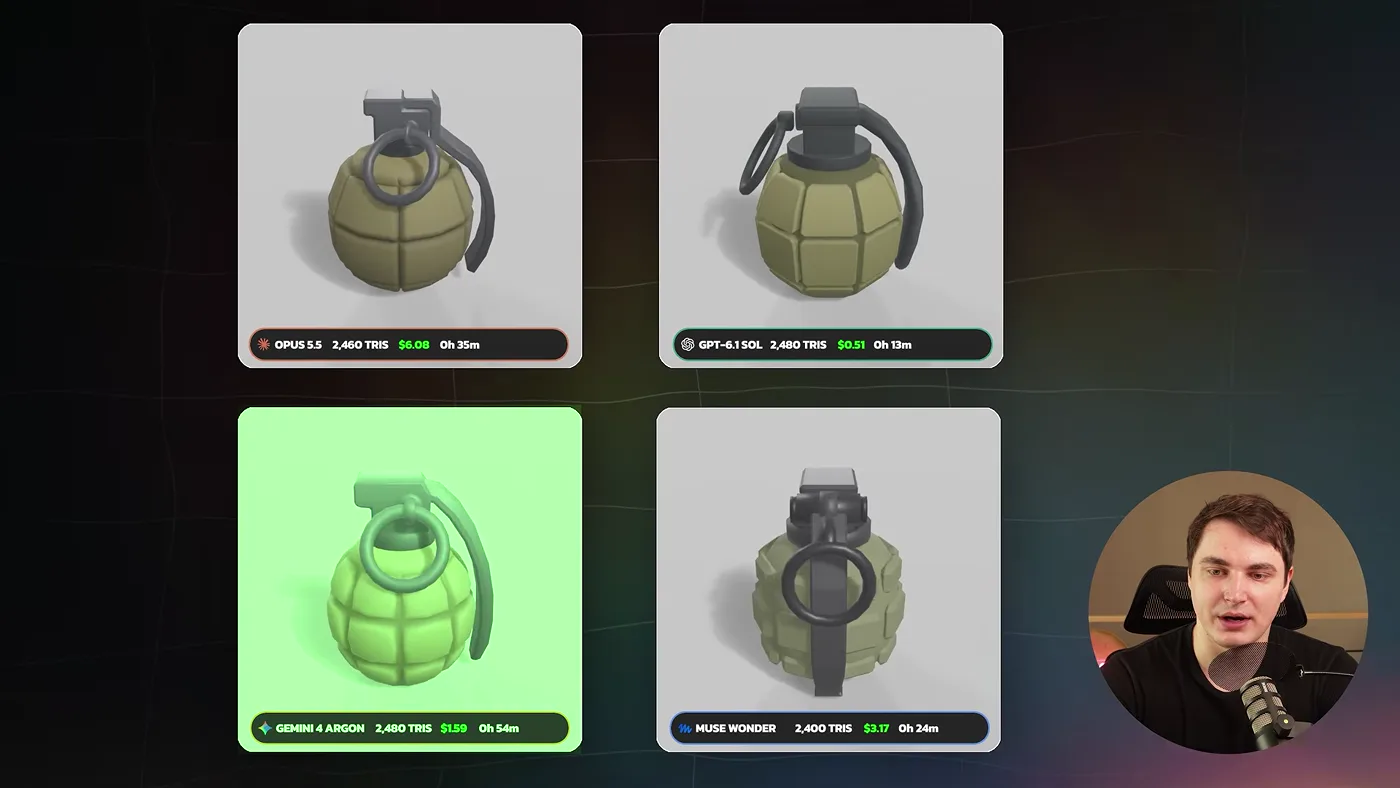
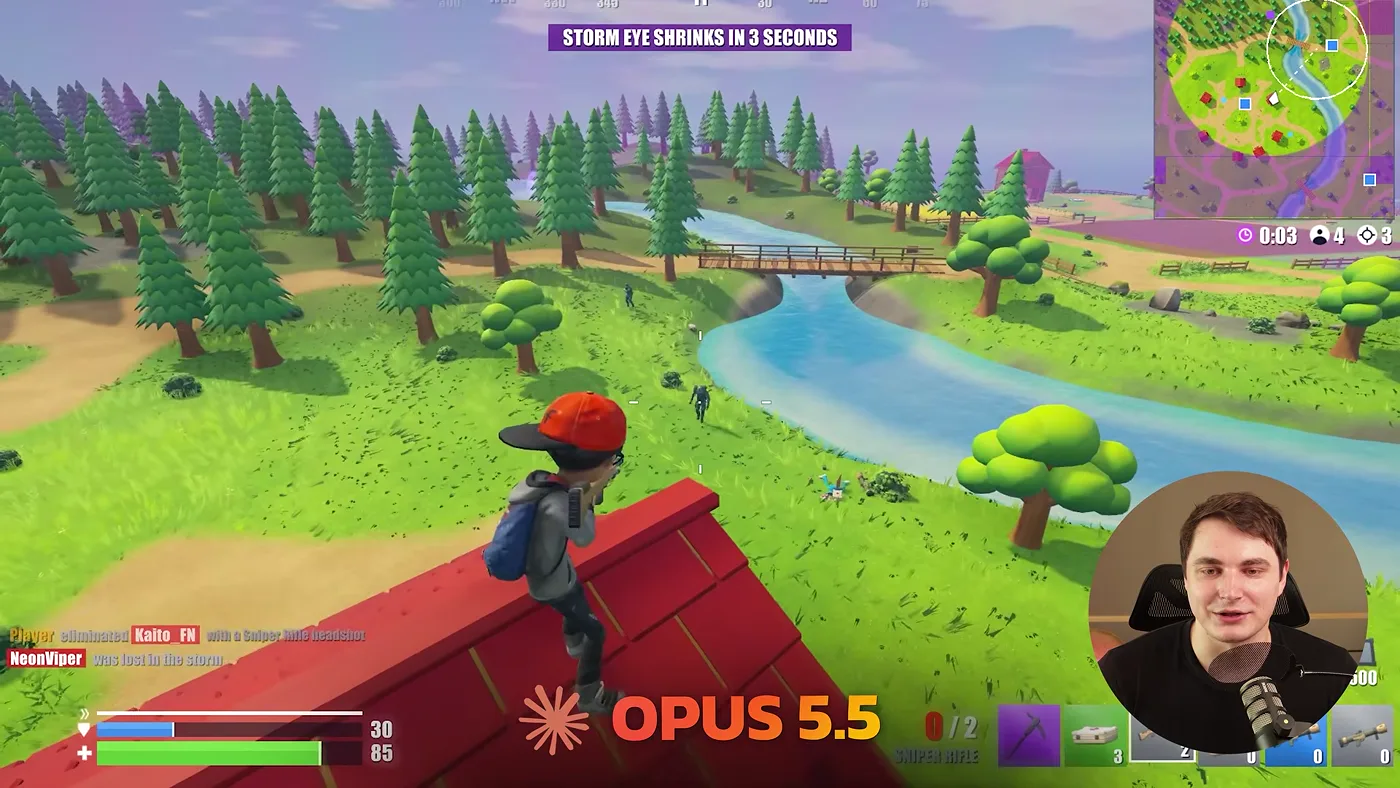
| Posição | Modelo | Props | Mapa | Jogo | Tempo do agente | Tokens | Custo da API |
|---|---|---|---|---|---|---|---|
| 1 | Claude Opus 5.5 | 2nd | 1st | 1st | 23 h 59 m | 778.9M | $282.29 |
| 2 | Gemini 4 Argon | 1st | 2nd | 2nd | 39 h 33 m | 302.7M | $132.59 |
| 3 | Meta Muse Wander | 4th | 4th | 3rd | cerca de 30 h | cerca de 183M | $191.71 |
| 4 | GPT-6.1 Sol | 2nd | 3rd | 4th | 41 h 50 m | 280.7M | $93.82 |
O Opus 5.5 foi o mais caro e também o mais rápido: 778.9 milhões de tokens e $282 em menos de 24 horas de trabalho do agente. O GPT-6.1 Sol foi o mais barato, a $94, mas foi o que rodou por mais tempo e seu jogo pareceu travado em todos os aspectos: um rifle congelado, sem feedback ao pegar itens, um míssil no lugar de uma bala. O Muse Wander teve o visual mais simples, mas a jogabilidade foi melhor que a do Sol, e a IA que compilou meus relatórios concordou.
5. Modelos de pesos abertos: Kimi K3.1 Pro e DeepSeek 4.1
O código aberto está de volta ao 3D. Pelos próprios números da Moonshot, o Kimi K3.1 Pro fica em segundo no Terminal Bench logo atrás do Opus 5.5, então rodei ele e o DeepSeek 4.1 Flash contra o Gemini 4 e o Opus 5.5 em nove testes. Rodei ambos os modelos abertos dentro do harness do Claude Code: em seus próprios harnesses (o Kimi Code, por exemplo), eles são mais baratos, mas mais preguiçosos, porque o Claude Code força o modelo a iterar.
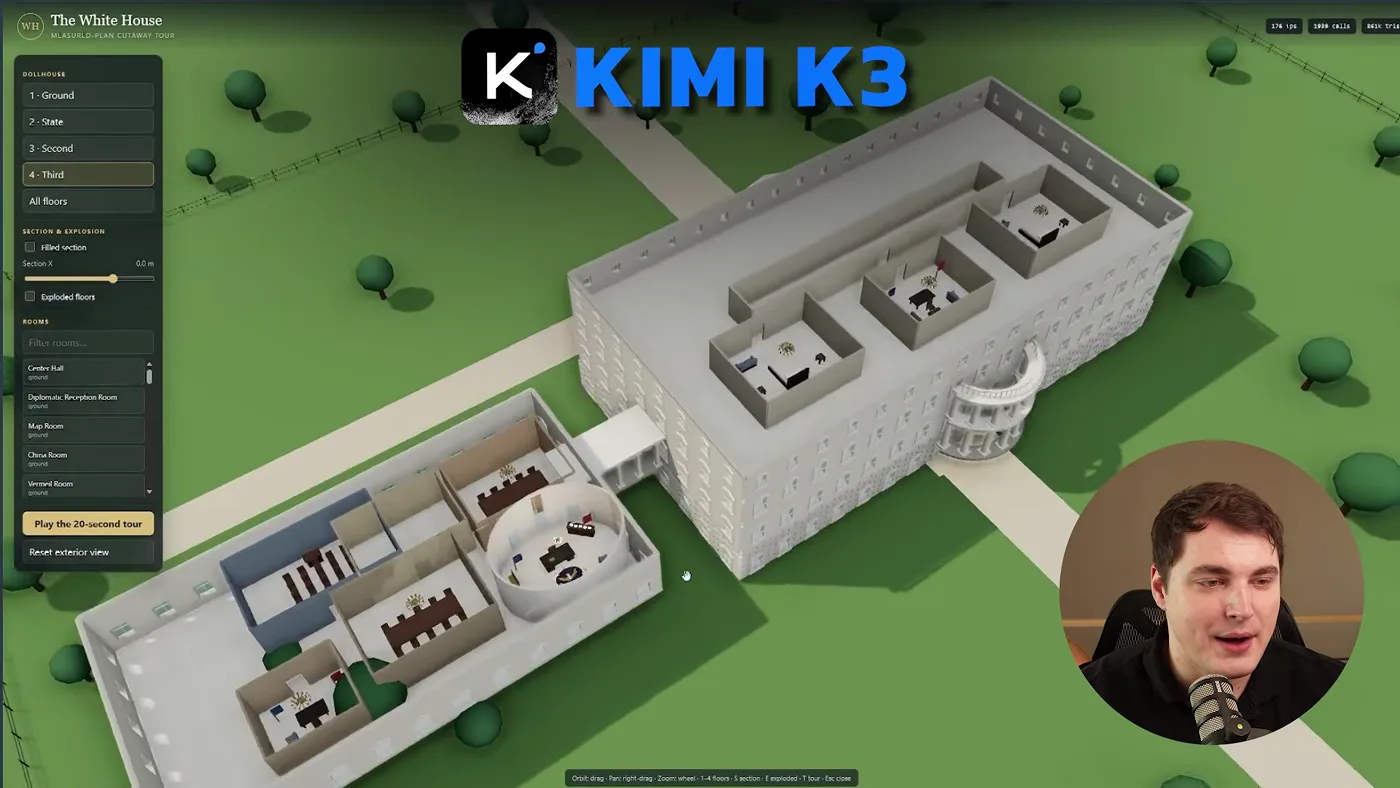
- O Opus 5.5 ainda venceu a maioria dos testes: o pouso da Apollo, a Casa Branca explorável, a montagem da Kawasaki H2 e a baleia saltando da água.
- O Kimi K3.1 Pro ficou perto do Gemini 4 e o venceu na transformação de carro para robô. Ele escolheu o caminho mais difícil no grou de origami e terminou em segundo, e seu jogo de pequenos planetas teve os controles mais bem ajustados entre os quatro.
- O DeepSeek 4.1 custou quase nada e criou um jogo de pinball surpreendentemente bom; a bola do Gemini 4 ficava presa todas as vezes.
- A ressalva do preço: pela API do Kimi, as leituras de cache ($0.20 por milhão de tokens) levaram meus custos de teste para perto do Opus 5.5. Pelo Kimi Code ou no seu próprio hardware, ele é muito mais barato; por token, é cerca de 5 vezes mais barato que o GPT-6 Astra.
A DeepSeek liberou seus pesos, e a Moonshot afirmou que os pesos do Kimi K3 chegariam ao Hugging Face no início de novembro. Em uma rodada anterior em agosto, o Grok ficou à frente do GLM 5.3 de pesos abertos e do Qwen 3.8 Max. O GLM 5.3 foi bem, mas sua API continuava falhando no esforço máximo, e o Qwen 3.8 Max foi o que mais falhou. Se você precisa manter o trabalho nos seus próprios servidores, o GLM 5.3 e o Kimi K3.1 são os que você deve testar.
6. A configuração importa tanto quanto o modelo
Cada resultado nesta página depende de como o modelo se conecta ao Blender. Antes de culpar um modelo, verifique estas três coisas.
- MCP, e não computer use. Com o computer use, o GPT-6 Astra precisou de 10 minutos só para salvar um arquivo. Um servidor MCP (o Blender MCP oficial ou o Higgsfield Blender plugin gratuito) permite que o modelo chame o Blender diretamente e veja a cena.
- O CLI do próprio modelo em esforço máximo. Claude Code para o Opus, Codex CLI para o GPT-6, o Antigravity CLI para o Gemini. Janelas de chat não conseguem rodar sua cena.
- Geradores 3D quando a qualidade importa. Eu os proibi no teste do Fortnite para avaliar os modelos; para trabalho em produção, deixar o agente chamar o Tripo P2 ou o Hi3D gera assets muito melhores, em vez de usar primitivas.
Eu rodo tudo isso a partir do meu workspace gratuito, o Mr Mak Workspace on GitHub, que agora suporta Claude Code, Codex e Antigravity lado a lado. Os guias completos de instalação estão no setup do GPT-6 Astra e no setup do Claude + Blender.
7. Onde todos os modelos ainda falham
Quanto custa e quanto tempo leva
Em junho, o Opus 4.8 e o GPT-5 ainda sofriam para posicionar objetos prontos com a rotação correta. Hoje, o Opus 5.5 e o GPT-6 Astra constroem cenas completas, fazem o rigging de criaturas e entregam jogos jogáveis, e a diferença entre eles se resume a gosto e orçamento. Minha escolha padrão é o Opus 5.5 para qualquer coisa que se mova e o GPT-6 Astra para qualquer coisa com cromado. Mantenho o Gemini 4 para lotes baratos de props e fico de olho no Kimi para o dia em que os pesos abertos alcançarem o mesmo nível.
Guias relacionados neste site: a configuração do GPT-6 Astra para 3D, a configuração do Claude + Blender, o Kimi K3 criando dez jogos na Unity e um LLM local gratuito criando um jogo na Unreal Engine 5.8.
Todos os testes, no YouTube
- 7 de nov. de 2026 Fortnite in Unity: Opus 5.5 vs GPT-6.1 vs Gemini 4 vs Muse
- 25 de out. de 2026 Kimi K3.1 Pro vs DeepSeek 4.1 vs Gemini 4 vs Opus 5.5
- 15 de out. de 2026 Gemini 4 Argon vs Opus 5.5 in 3D and Blender
- 27 de set. de 2026 Opus 5.5 reruns my Blender tests from a year ago
- 24 de set. de 2026 Claude Opus 5.5 vs GPT-6 Astra: 10 Blender tests
- 7 de set. de 2026 GPT-6 Astra in Blender (vs Fable 5.1)
- 26 de ago. de 2026 GLM 5.3, Qwen 3.8 Max and Grok on 3D tasks
Última atualização em 9 de novembro de 2026. Os próximos da lista: Gemini 4 Carbon e Muse Wonderful, assim que eu conseguir acesso.