Stefan Vaskevich
Herramientas usadas en este artículo

Escribes "una persona realiza una patada giratoria de artes marciales" y obtienes una animación utilizable, en tu propia computadora, sin entorno de Python y sin llamadas de red. Eso es Kimodo, el modelo de difusión de movimiento de NVIDIA, y alguien lo portó a C++ y GGML para que se ejecute en Vulkan o en un procesador convencional con menos de 2 GB de memoria.
Pasé un día instalándolo desde cero en Windows, generando clips y llevándolos a rigs de Mixamo y a Unreal Engine. Esta guía es todo lo que aprendí, incluidas las dos cosas que más tiempo me costaron y que no están en ningún README: qué modelos realmente tienes permitido usar y por qué todo el proceso está limitado por tu disco y no por tu tarjeta gráfica.
1. Qué es Kimodo y qué cambió el port de C++
NVIDIA lanzó Kimodo en marzo de 2026. Es un modelo cinemático de difusión de movimiento entrenado con 700 horas de captura de movimiento óptica con licencia comercial, y convierte prompts de texto y restricciones cinemáticas dispersas en movimiento 3D de humanos y robots humanoides. Se distribuye en tres formatos de esqueleto: el cuerpo paramétrico SOMA propio de NVIDIA, el robot humanoide Unitree G1 y SMPL-X.
El lanzamiento original es un proyecto de PyTorch. Necesitabas tener configurado todo el stack de CUDA antes de poder generar un solo clip, lo cual es una verdadera barrera para cualquiera cuya computadora esté configurada para trabajo 3D en lugar de aprendizaje automático.
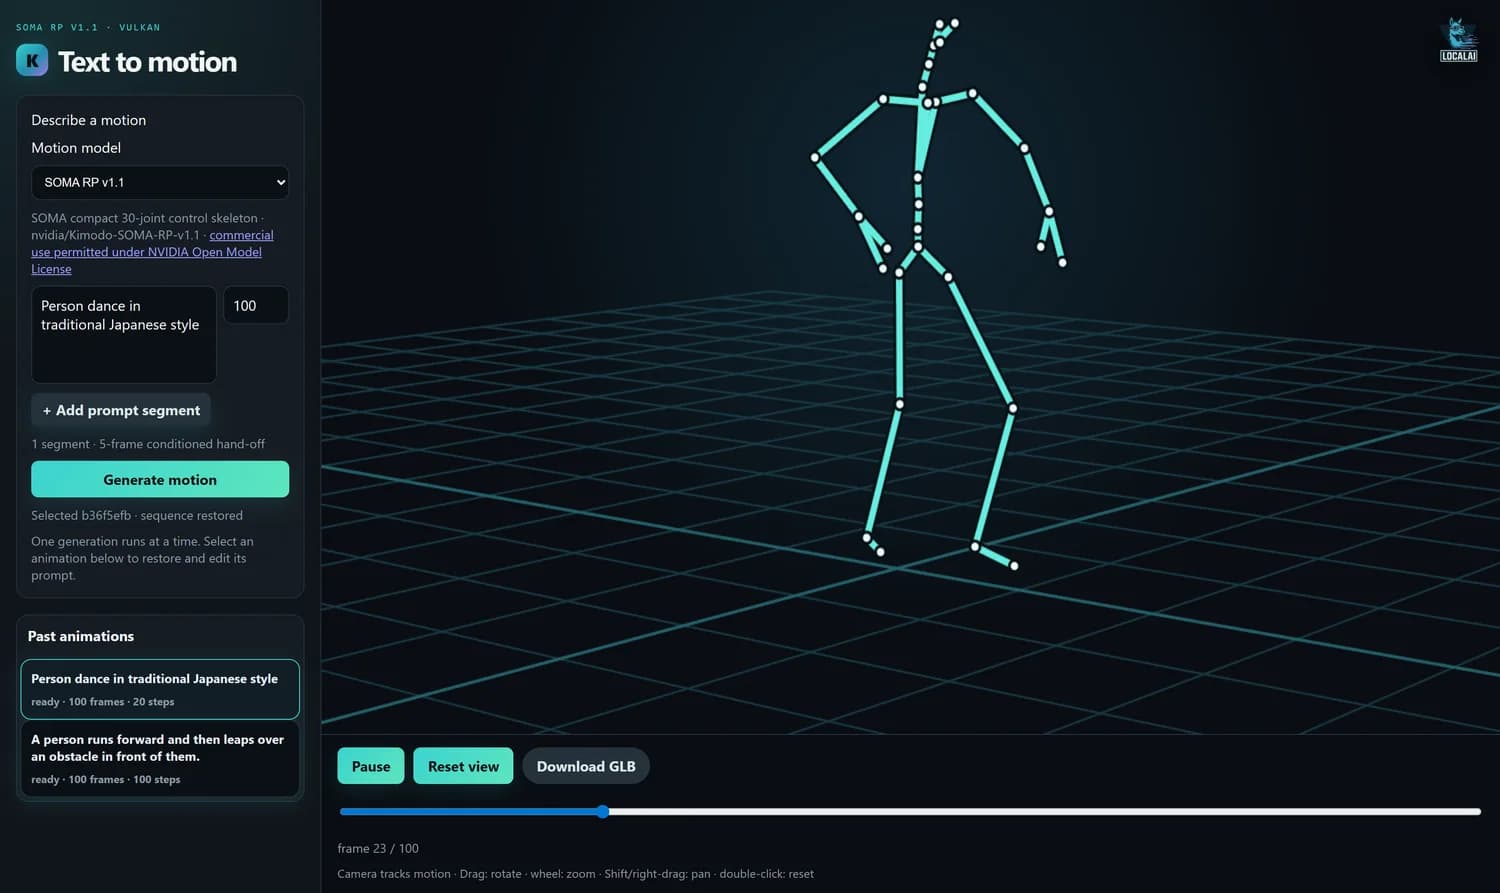
kimodo.cpp es un port nativo en C++ y GGML. Carga pesos GGUF, se ejecuta en Vulkan o en el procesador e incluye una pequeña interfaz web local. Sin Python al momento de generar, sin CUDA, sin red. Eso es todo, y es más importante de lo que parece, porque hace que Kimodo pase de ser "algo que ejecuta la gente de ML" a "algo que abres en tu estación de trabajo".
2. La situación de la licencia, que cambió el 26 de agosto
Esta es la parte en la que se equivoca la mayoría de los artículos, porque cambió hace poco y en ambas direcciones a la vez.
Originalmente, el port incluía pesos convertidos de SMPL-X. Esos fueron retirados. El autor notó que la licencia original de NVIDIA en ese checkpoint en particular prohíbe explícitamente distribuir modelos derivados, y retiró el GGUF, el manifiesto y los checksums. La model card que los reemplazó lo dice claramente en lugar de dejar atrás un misterioso error 404, lo cual agradezco más de lo que esperaba.
Casi al mismo tiempo, se publicaron otros cuatro checkpoints bajo una licencia completamente diferente y se agregó compatibilidad con ellos al port.
| Modelo | Esqueleto | Licencia | Uso comercial |
|---|---|---|---|
| SOMA RP v1.1 | SOMA, 30 articulaciones | NVIDIA Open Model | Permitido |
| SOMA SEED v1.1 | SOMA, 30 articulaciones | NVIDIA Open Model | Permitido |
| G1 RP v1 | Unitree G1, 34 articulaciones | NVIDIA Open Model | Permitido |
| G1 SEED v1 | Unitree G1, 34 articulaciones | NVIDIA Open Model | Permitido |
| SMPL-X RP v1 | SMPL-X, 22 articulaciones | NVIDIA Internal Scientific R&D | Solo investigación |
La interfaz es honesta al respecto, lo cual no esperaba de un port de fin de semana. Eliges un modelo y te dice qué licencia se aplica antes de generar cualquier cosa.
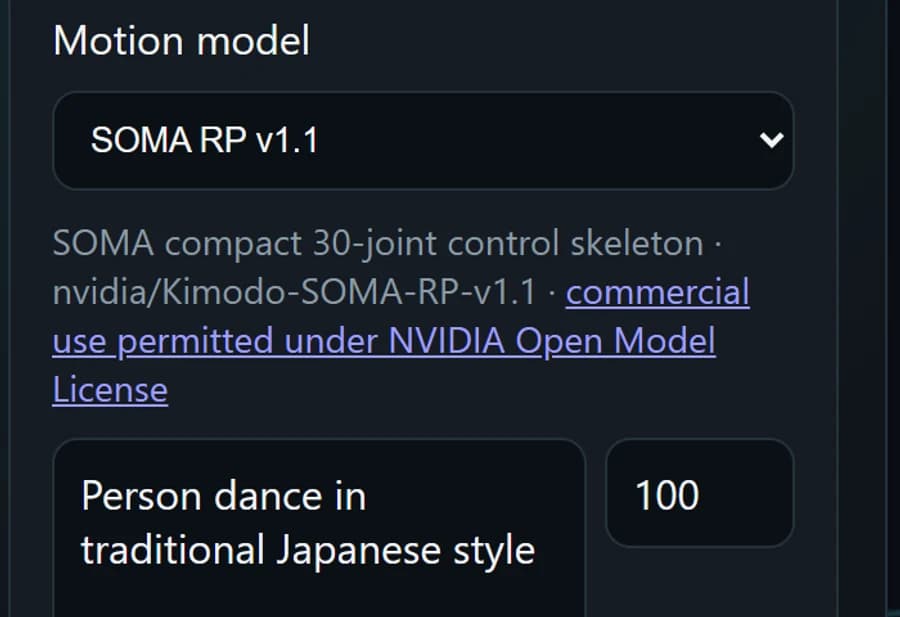
3. Qué hardware necesitas realmente
Los requisitos son bajos, pero vale la pena entender por qué son bajos en vez de limitarse a leer una tabla.
| Recurso | Mínimo | Cómodo |
|---|---|---|
| Espacio libre en disco | 25 GB | 35 GB, en una unidad NVMe |
| RAM del sistema | 4 GB | 32 GB, y consulta la sección 5 |
| VRAM, ejecución con GPU | 1.2 GB | 2 GB |
| CPU | 2 núcleos | 6 núcleos |
El uso máximo de memoria se mantiene por debajo de 2 GB en todas las configuraciones, ya sea con GPU o con procesador. El parámetro es KIMODO_TEXT_LAYER_CHUNK, y el número que acepta indica capas, no gigabytes: el chunk 2 usa 1.2 GB de VRAM, el chunk 4 usa 1.8 GB y el chunk 8 predeterminado usa 3.5 GB. Aumentarlo no acelera nada, porque el encoder se lee una vez por ejecución, sin importar el tamaño del chunk.
Hay un límite mínimo estricto en torno a 1.3 GB. La tabla de embeddings es una única asignación de 1.05 GB que no se puede dividir con ningún tamaño de chunk, por lo que por debajo de eso el programa no puede iniciarse en absoluto.
4. Cómo instalarlo en Windows
El proyecto documenta Linux. Windows funciona y el archivo CMake tiene una rama específica para MSVC, pero hay cuatro puntos donde puedes perder una hora. Aquí está la versión corta; puedes descargar la guía completa paso a paso al final de esta sección.
Instala el toolchain y luego abre una terminal nueva
Git, Visual Studio Build Tools con la carga de trabajo de C++, el Vulkan SDK y Go si quieres la interfaz web.
winget install Git.Git
winget install Microsoft.VisualStudio.2022.BuildTools --override "--quiet --wait --norestart --add Microsoft.VisualStudio.Workload.VCTools --add Microsoft.VisualStudio.Component.VC.CMake.Project --includeRecommended"
winget install KhronosGroup.VulkanSDK
winget install GoLang.Go
El componente VC.CMake.Project no es opcional. Sin él obtienes un compilador, pero no CMake ni Ninja, y el mensaje de error no menciona nada de esto. Luego cierra todas las terminales: el instalador de Vulkan configura VULKAN_SDK para todo el sistema y una terminal que ya esté abierta nunca detectará esa variable.
Clona con submódulos
git clone --recurse-submodules https://github.com/localai-org/kimodo.cpp
cd kimodo.cpp
GGML es un submódulo. Si clonas el repositorio sin incluir los submódulos, GGML queda vacío, y descargar el repositorio como ZIP tampoco funciona por la misma razón.
Aplica dos correcciones al código fuente y luego compila
Agrega #include <stdexcept> a src/denoiser.cpp, src/generate.cpp y src/llm_tokenizer.cpp, y cambia path.c_str() por path.string().c_str() en src/llm_text_encoder.cpp. Ambas correcciones son correctas en todas las plataformas y simplemente no se han incorporado upstream. Luego, desde una terminal donde se haya ejecutado vcvars64.bat:
cmake -S . -B build-win -G Ninja -DCMAKE_BUILD_TYPE=Release -DKIMODO_ENABLE_VULKAN=ON -DKIMODO_BUILD_TESTS=OFF
cmake --build build-winDescarga los pesos
El encoder de texto es compartido por todos los modelos, así que es una descarga única de 15.2 GB. Cada modelo de movimiento suma solo alrededor de 1.13 GB adicionales.
pip install huggingface_hub
hf download LocalAI-io/Llama-3-Kimodo-GGML --local-dir . --include "generated/llm2vec-text-bundle/*"
hf download LocalAI-io/Kimodo-SOMA-RP-v1.1-GGML --local-dir . --include "models/*"
Agregar los cuatro modelos con licencia abierta ocupa alrededor de 4.5 GB, y no cuatro veces 17, porque el encoder es compartido.
hf download con --include no coincide con nada y finaliza con éxito. Sin errores, sin archivos, código de salida cero. Mi script de configuración reportó una ejecución limpia y solo me di cuenta de que faltaba el modelo cuando falló la generación. Siempre verifica que el .gguf realmente haya quedado en models\.Cada comando, ambas correcciones al código fuente con los errores exactos que evitan, todas las variables de entorno y una tabla de solución de problemas que vincula cada síntoma con su causa real. Escrito después de hacer esto en una máquina sin ningún compilador instalado.
kimodo-windows-setup.md5. Cómo generar tu primer clip
La línea de comandos es posicional y las DLL de GGML se encuentran en la carpeta bin del árbol de compilación, en lugar de estar junto al ejecutable. Si pasas eso por alto, el programa se cierra al instante sin mostrar nada. Parece un cierre inesperado, pero en realidad Windows no puede cargar una DLL.
set PATH=%CD%\build-win\bin;%PATH%
build-win\kmd-generate.exe models\kimodo-soma-rp-v1.1-f32.gguf generated\llm2vec-text-bundle prompt.txt 90 20 41 out
Son 90 frames a 30 fps, es decir, tres segundos, con 20 pasos de denoising y la semilla 41. Si prefieres usar la interfaz web:
go run ./demo -addr 127.0.0.1:8094 -generator build-win/kmd-generate.exeDos números determinan la calidad del resultado. Con Frames, el movimiento se mantiene coherente hasta unos 300 frames, o diez segundos. A los 400 frames el clip presenta jitter y a los 600 se convierte en ruido aproximadamente después del frame 300. Aunque parezca contradictorio, los clips más cortos resultan más contundentes: el mismo prompt a 120 frames produce un movimiento más definido y atlético que a 300, porque el modelo rellena el tiempo extra en lugar de repetir la acción con más fuerza.
Steps es la cantidad de pasos de denoising, y 20 funciona tanto para borradores como para resultados finales. El costo es lineal, así que 100 pasos cuestan cinco veces más sin ninguna mejora visible. La interfaz incluida actualmente tiene el valor 100 fijado en el código de demo/index.html; vale la pena cambiarlo a 20 antes de hacer algo serio con ella.
En mi computadora, con un Ryzen 7 7800X3D, 31 GB de RAM y los pesos en un SSD SATA, un clip de tres segundos tardó 399 segundos. De ese tiempo, aproximadamente 380 segundos fueron de lectura del disco y 10 segundos de uso de CPU. La RTX 4070 SUPER estuvo inactiva todo el tiempo. La unidad entregaba 40 MB/s, y 15.2 GB a 40 MB/s son 380 segundos. La cuenta cierra exactamente.
Dos soluciones, en orden de efectividad: pon los pesos en una unidad NVMe y libera RAM antes de generar. El encoder necesita aproximadamente 16 GB libres en la caché de archivos para permanecer en ella, y una computadora de 32 GB con un navegador y un cliente de chat abiertos solo tiene unos 7 GB disponibles para esa caché, por lo que se comporta como una computadora de 16 GB.
6. Cómo llevar el movimiento a un rig real
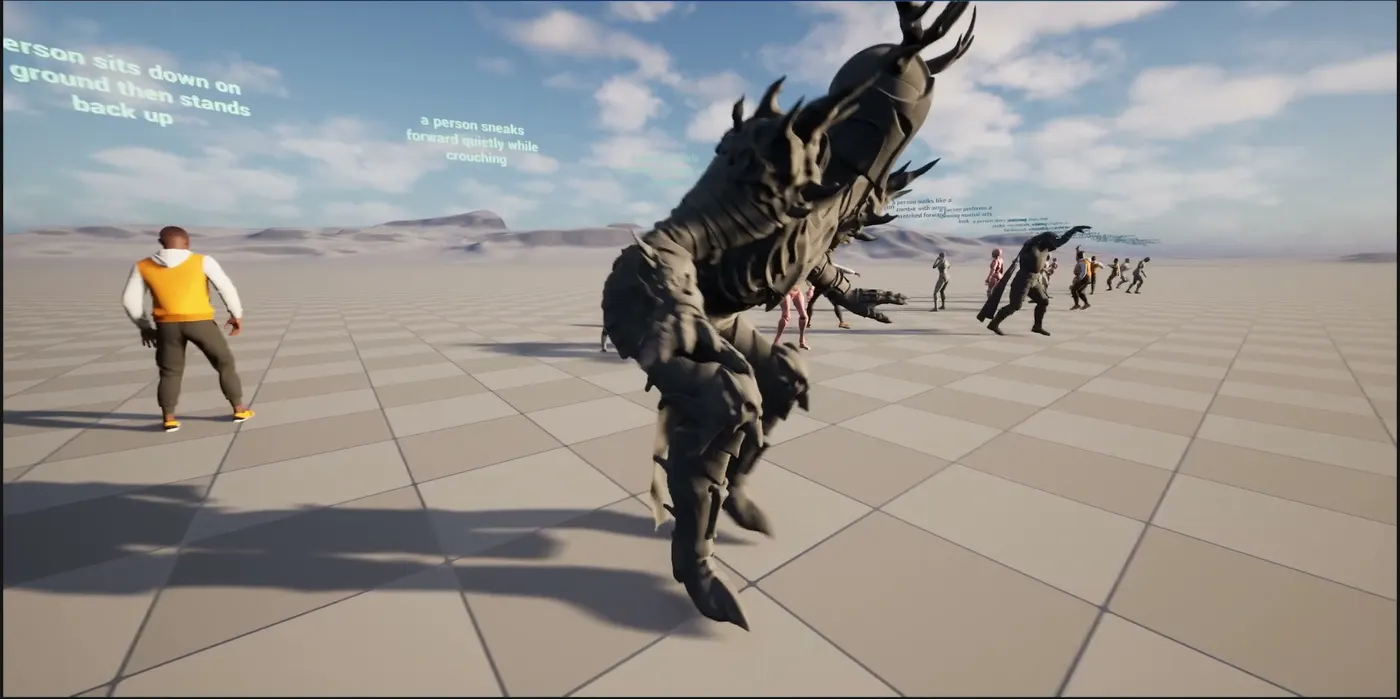
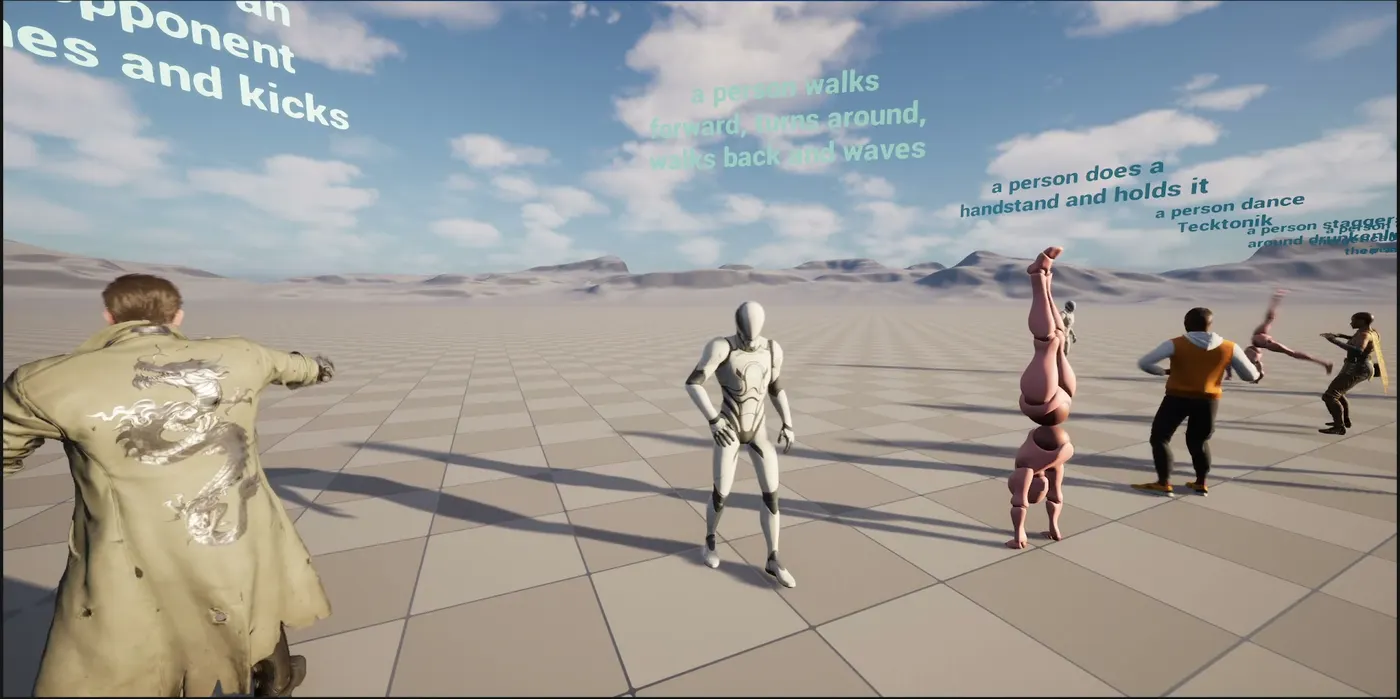
Generar es la parte fácil. Este port resulta interesante para un artista 3D, más que para un investigador, porque el resultado se puede aplicar a un rig de personaje común sin demasiadas complicaciones.
La interfaz web tiene un botón Download GLB. El servidor de demostración genera el archivo glTF, así que obtienes un archivo que se abre en Blender con una jerarquía de huesos y keyframes ya configurados. Para la mayoría de los trabajos, eso es todo lo que necesitas y puedes saltarte los detalles de formato que vienen a continuación.
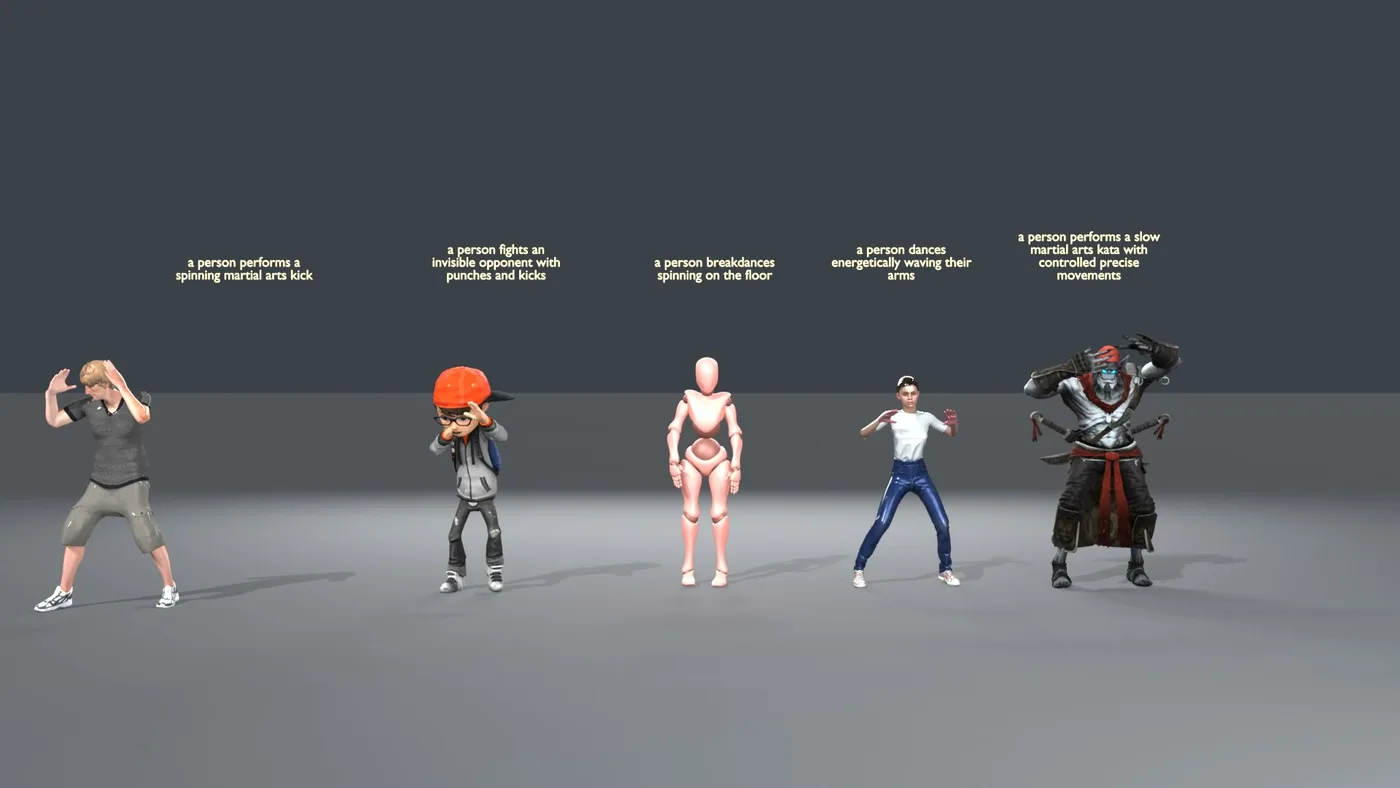
Aquí es donde SOMA resulta ser un golpe de suerte. No utiliza para nada la convención de nomenclatura de SMPL-X. Sus 30 articulaciones se llaman Hips, Spine1, LeftShoulder, LeftForeArm y así sucesivamente, lo cual sigue casi exactamente la convención de Mixamo. La mayoría de los huesos se mapean agregando el prefijo mixamorig: y nada más.
LeftLeg de SOMA es el muslo. El mixamorig:LeftLeg de Mixamo es la espinilla. El mapeo correcto es de LeftLeg de SOMA a mixamorig:LeftUpLeg, y de LeftShin de SOMA a mixamorig:LeftLeg. Un mapeo solo con prefijos te da un personaje cuyas rodillas se doblan desde la cadera, y es lo primero que debes revisar cuando una transferencia se ve mal.Para Unreal dejé de hacerlo a mano. Más abajo hay una herramienta de dos scripts que toma una carpeta de clips y te deja una Anim Sequence horneada en el maniquí. Maneja los tres esqueletos sin ninguna configuración porque la cantidad de articulaciones permite identificar de cuál se trata.
De clip a archivo, en tu escritorio
Python 3.8 o una versión más reciente, sin nada más. Sin Blender, sin paquetes. Indícale la carpeta que creó Kimodo y obtienes un .glb.
python kimodo_to_glb.py path/to/clip
python kimodo_to_glb.py clips/* --outdir glb
Verifica su propia salida antes de escribir: reconstruye la pose a partir del archivo que acaba de crear y la compara con la entrada, de modo que un eje incorrecto o un cuaternión con el orden de componentes equivocado se detecta aquí en lugar de tres pasos más adelante en Unreal. El número que imprime debería estar alrededor de 1e-08.
De archivo a personaje, dentro de Unreal
Abre el Output Log, cambia la casilla de entrada en la parte inferior de Cmd a Python y pega:
py "C:/path/to/unreal_retarget.py" "C:/path/to/walk_150.glb"Eso importa el archivo, construye el IK Rig y el IK Retargeter, aplica las dos correcciones que se detallan abajo, hornea y deja una Anim Sequence en /Game/Kimodo/Retargeted/. Coloca el maniquí en tu nivel, establece Animation Mode en Use Animation Asset y selecciona la secuencia. Pasa varias rutas para procesarlas en lote, o añade al final una ruta de Skeletal Mesh para usar otro personaje como destino.
Genera un informe para cada clip para que no tengas que comprobarlo a ojo:
kick_120: SMPL-X, 22 joints
    9 chains mapped, 19 left at rest (Root, LeftThumb, ...)
    reach 102 cm to 95 cm, arms corrected by up to 48 deg
    arms match 0.998 (worst lowerarm_r), pelvis 93 cm, lowest toe -1 cm,
    travelled 123 cm over 4.0 s
arms match mide qué tan bien coincide la dirección de los brazos del personaje con la de los brazos de origen en distintos momentos del clip. Por encima de 0.95 es un buen valor. lowest toe debería estar cerca de cero: muy por encima y el personaje flota, muy por debajo y se hunde.
Las poses de reposo no coinciden. El maniquí reposa en una pose en A, Kimodo no. Si se deja así, el retargeter interpreta esa diferencia como movimiento y los brazos quedan mal durante todo el clip. El script mide ambas poses y compensa la diferencia en cada segmento del brazo, empezando por el padre y siguiendo con el hijo. Por lo general, la diferencia es de entre 45 y 55 grados.
local_rotations_xyzw.f32 en [FRAMES, JOINTS, 4] y root_positions.f32 en [FRAMES, 3]. La tabla de formato publicada indica 22 articulaciones, y eso es solo para SMPL-X. SOMA tiene 30 y G1 tiene 34.Un clip de SOMA de 90 fotogramas tiene exactamente 90 x 30 x 4 x 4 = 43,200 bytes. Léelo con un stride de 22 articulaciones y no obtendrás ninguna excepción ni advertencia, pero sí una animación que parece como si el rig tuviera convulsiones. Deduce la cantidad de articulaciones a partir del tamaño del archivo en lugar de dejarla fija en el código.
Los dos scripts, un clip de ejemplo para que puedas probar la parte de Unreal sin generar nada antes, y las notas: la jerarquía completa de SOMA de 30 articulaciones con índices padre, el mapa completo de nombres de Mixamo incluyendo los huesos que no se mapean de forma directa, la trampa del orden de los cuaterniones y el procedimiento para Blender.
Resumen
| Etapa | Costo | Notas |
|---|---|---|
| Instalación de la toolchain | ~30 min, ~3 GB | Build Tools, Vulkan SDK, Go |
| Compilación | ~2 min | Primero dos correcciones de una sola línea en el código fuente |
| Pesos | 15.2 GB + 1.13 GB cada uno | Encoder compartido entre todos los modelos |
| Generación, en caliente | ~20 s de cómputo | Más streaming desde el disco, consulta la sección 5 |
| Retarget a Mixamo | Minutos | Mapa de nombres más la corrección de las piernas |
La noticia no es que exista un modelo de texto a movimiento. Es que este ahora funciona en hardware que ya tienes, bajo una licencia que te permite publicar el resultado y se adapta a un rig de Mixamo en una tarde. Lo que más me sorprendió es que el cuello de botella es la lectura de disco, no una tarjeta gráfica, lo que significa que la mejora más económica para cualquiera que se tome esto en serio es una unidad NVMe en lugar de una mejor GPU.
Si quieres conocer el resto del pipeline que lleva hasta aquí, tenemos guías sobre el pipeline completo de personajes 3D con IA, rigging con IA para personajes no humanoides y HY-Motion, el otro modelo de texto a animación que vale la pena conocer.