Stefan Vaskevich
Herramientas usadas en este artículo


¿Qué modelo de IA es el mejor para Blender y 3D ahora mismo? Para la mayoría de los trabajos, Claude Opus 5.5. Ganó mi prueba de juego completo contra GPT-6.1, Gemini 4 y Muse de Meta, y superó a Gemini 4 y Kimi K3.1 Pro en casi todas las tareas de Blender. GPT-6 Astra es la opción para autos y barcos procedurales detallados, y los construye más rápido o más barato. Gemini 4 Argon es la opción económica, a menudo a un décimo del precio por tarea. Ninguno de ellos puede hacer el desplegado UV de un modelo todavía.
Esta página reúne siete de mis videos de comparación de agosto a noviembre de 2026: más de 40 pruebas en las que cada modelo recibió el mismo prompt, las mismas herramientas y el máximo esfuerzo. A continuación están el ganador para cada tipo de trabajo en 3D, los resultados mano a mano y lo que costó cada ejecución. Los costos corresponden a lo que costarían los mismos tokens a través de la API; ejecuté la mayoría de las pruebas con suscripciones. Actualizo esta página cuando se lanza un nuevo modelo.
La prueba más reciente: cuatro modelos construyen Fortnite en Unity
Props, mapa y un juego completo, con cada resultado y cada factura en pantalla.
1. El mejor modelo de IA para cada trabajo 3D
Ningún modelo gana en todo, así que aquí tienes la respuesta para cada tarea. «Segundo lugar» es el modelo al que recurriría si la primera opción es demasiado costosa o no está disponible para ti.
| Trabajo | Elección | Segundo lugar | Por qué |
|---|---|---|---|
| Un juego completo en Unity | Claude Opus 5.5 | Gemini 4 Argon | La única build que ofrecía la experiencia de juego que pedía el brief; también la más rápida de las cuatro (24 h de trabajo del agente) |
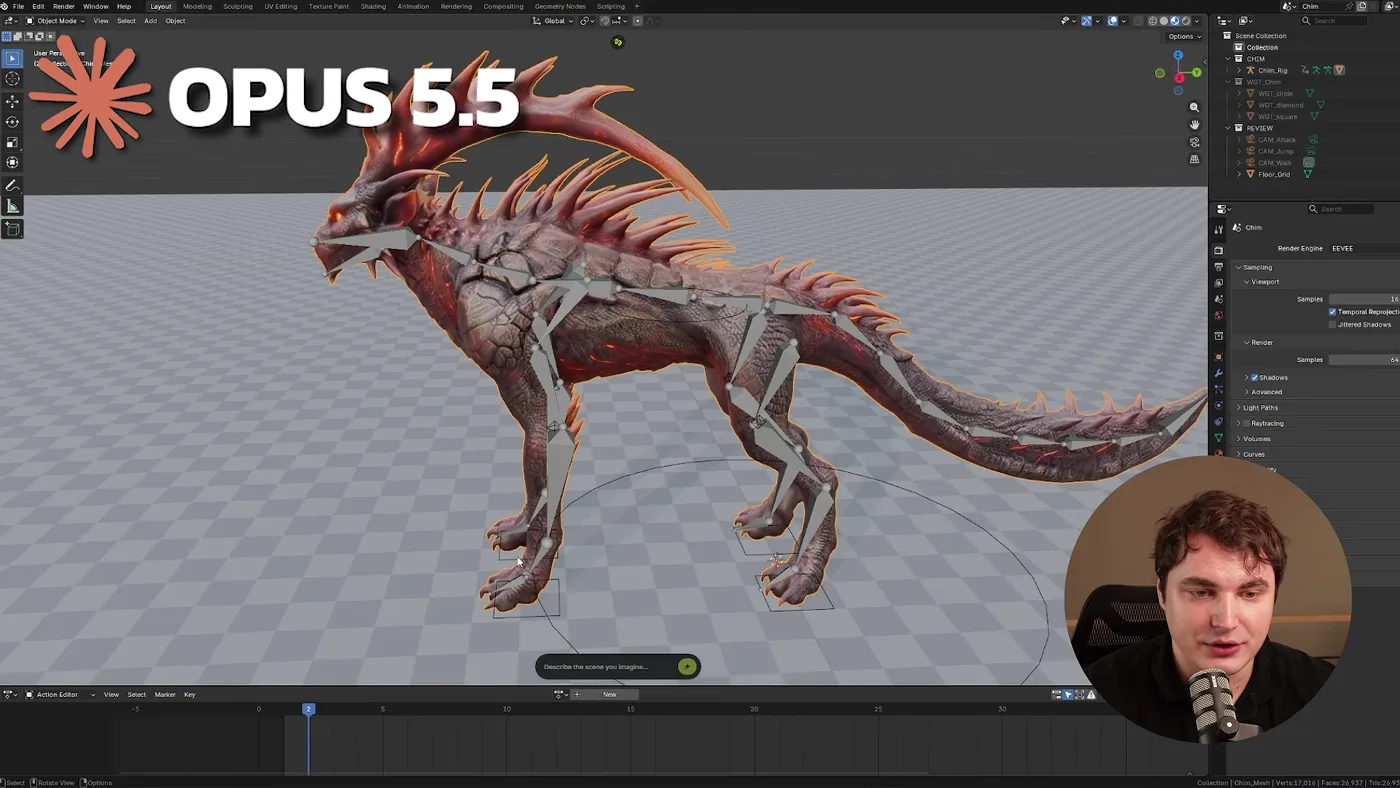
| Animación de criaturas y personajes | Claude Opus 5.5 | GPT-6 Astra | Misma calidad de rig, pero ciclos de salto y ataque claramente mejores, en 46 minutos frente a 63 |
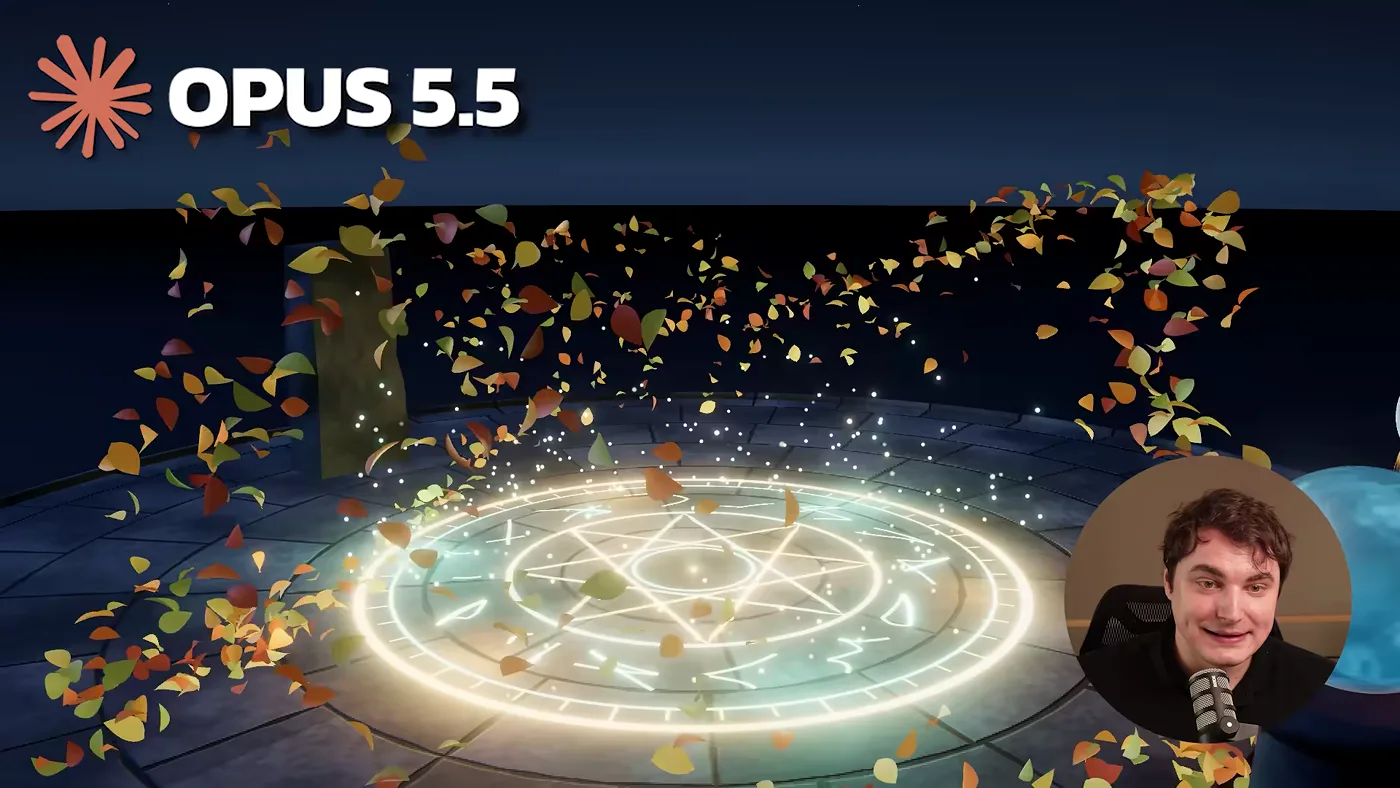
| VFX y shaders | Claude Opus 5.5 | GPT-6 Astra | El círculo mágico, el remolino de hojas y el trabajo de cámara estuvieron un nivel por encima |
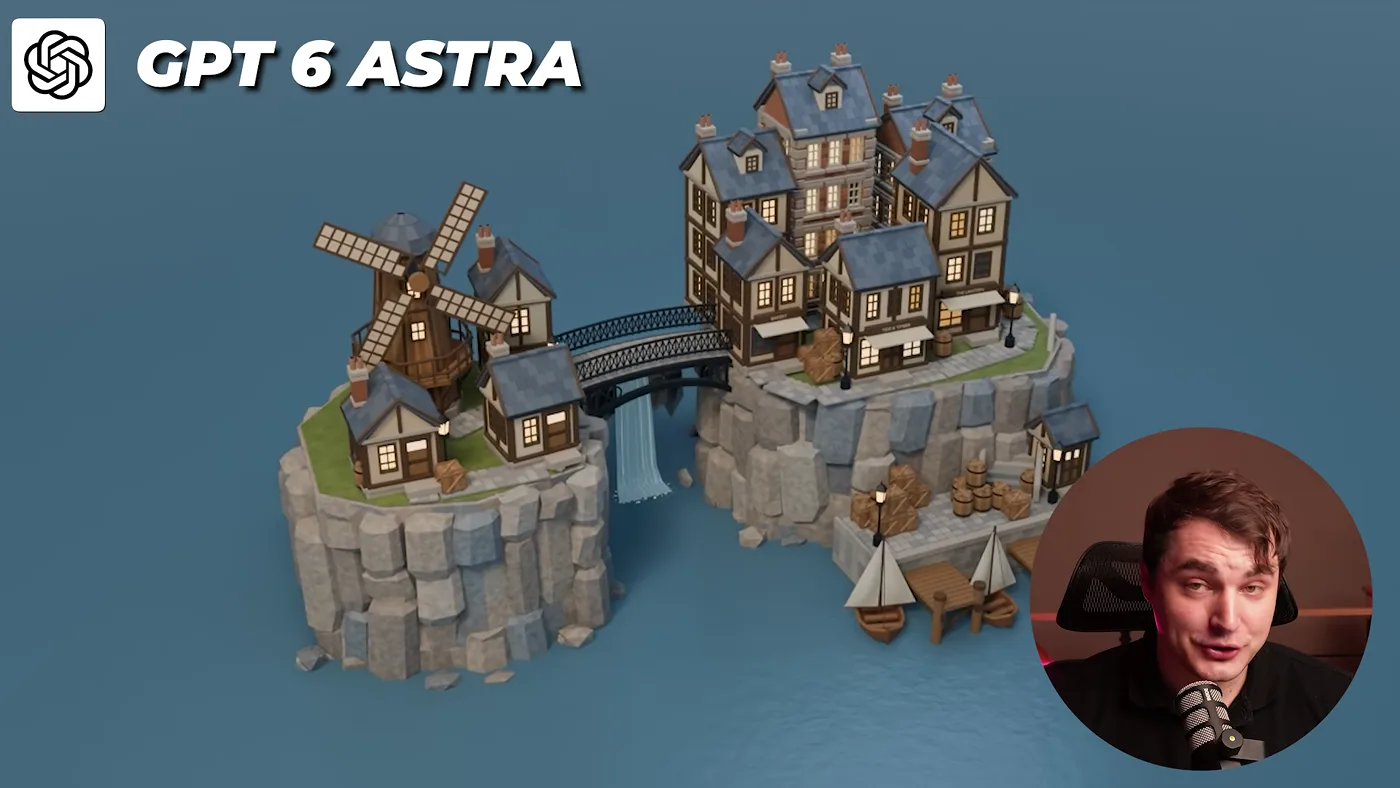
| Hard-surface procedural: autos, barcos | GPT-6 Astra | Claude Opus 5.5 | Más detalle en el Cadillac y el galeón; el galeón a cerca de la mitad del costo |
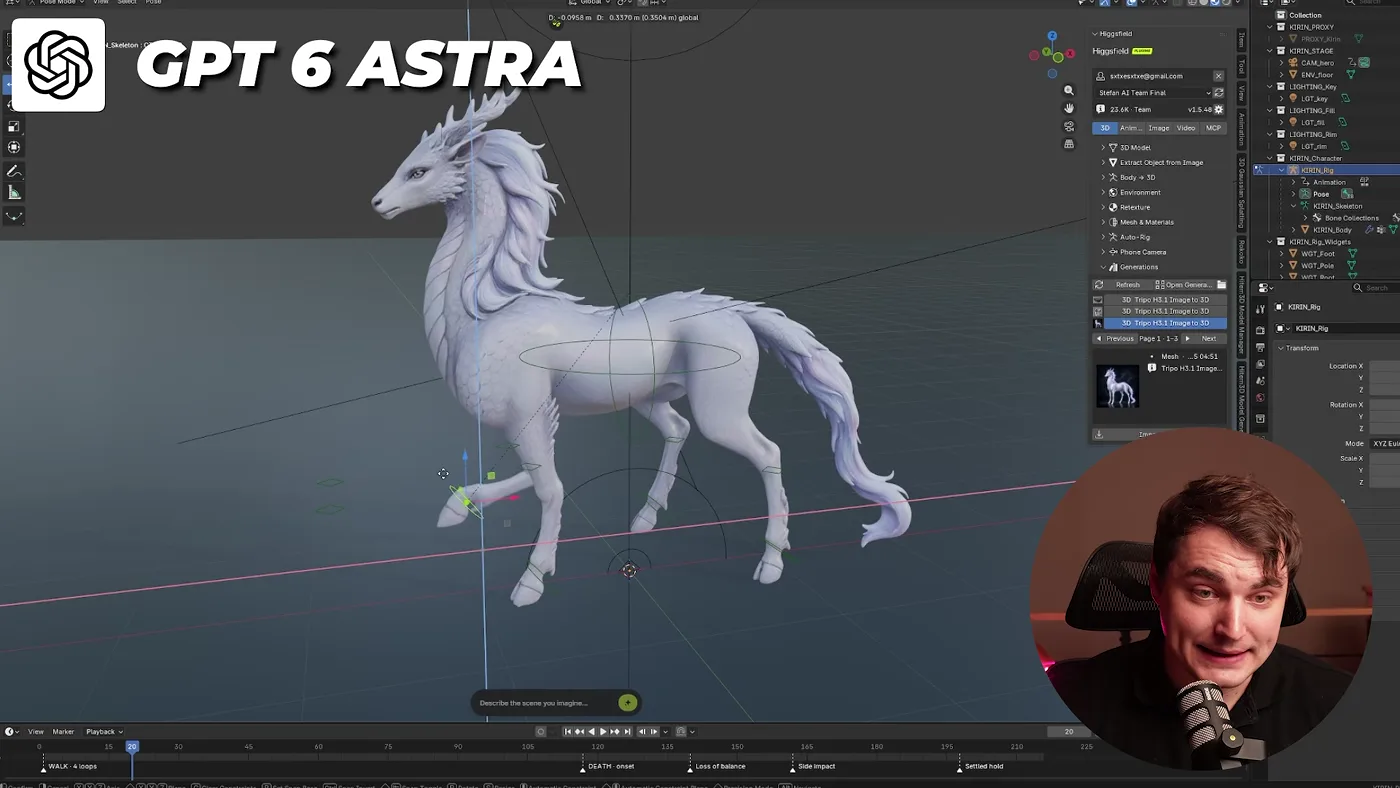
| Rigging de una criatura | GPT-6 Astra u Opus 5.5 | - | Ambos construyen un rig de control con IK; GPT-6 Astra lo hizo sin que se lo pidieran |
| Props individuales con poco presupuesto | Gemini 4 Argon | GPT-6.1 Sol | Los mejores props individuales en la prueba de Fortnite, a menudo a un décimo del precio de Opus; muy lento |
| Pesos abiertos que puedes ejecutar tú mismo | Kimi K3.1 Pro | DeepSeek 4.1 | Aproximadamente al nivel de Gemini 4 en mis pruebas, y superó a Gemini en varias de ellas |
| Desplegado UV | Ninguno de ellos | - | Tanto Opus 5.5 como GPT-6 Astra fallaron: islas diminutas, la mitad del espacio UV desperdiciado |
Una nota sobre los nombres, porque se vuelven confusos. GPT-6 Astra es el modelo de frontera de OpenAI. GPT-6.1 Sol es el nivel cotidiano más económico que perdió la prueba de Fortnite; su resultado no dice nada sobre Astra. Opus 5.5 es el segundo nivel de Anthropic por debajo de Fable, y en 3D compite de igual a igual con GPT-6 Astra de todos modos.
2. Claude Opus 5.5 vs GPT-6 Astra en Blender
Estos dos representan la competencia más reñida. Les di a ambos las mismas diez tareas con el máximo esfuerzo, cada uno en su propio entorno (Claude Code y Codex CLI), con acceso total a Blender mediante MCP y permiso para llamar a las API de generación 2D y 3D a través del plugin de Higgsfield. La mayor parte del tiempo prefirieron construir todo de forma procedimental de todos modos.
| Prueba | Ganador | Tiempo y costo |
|---|---|---|
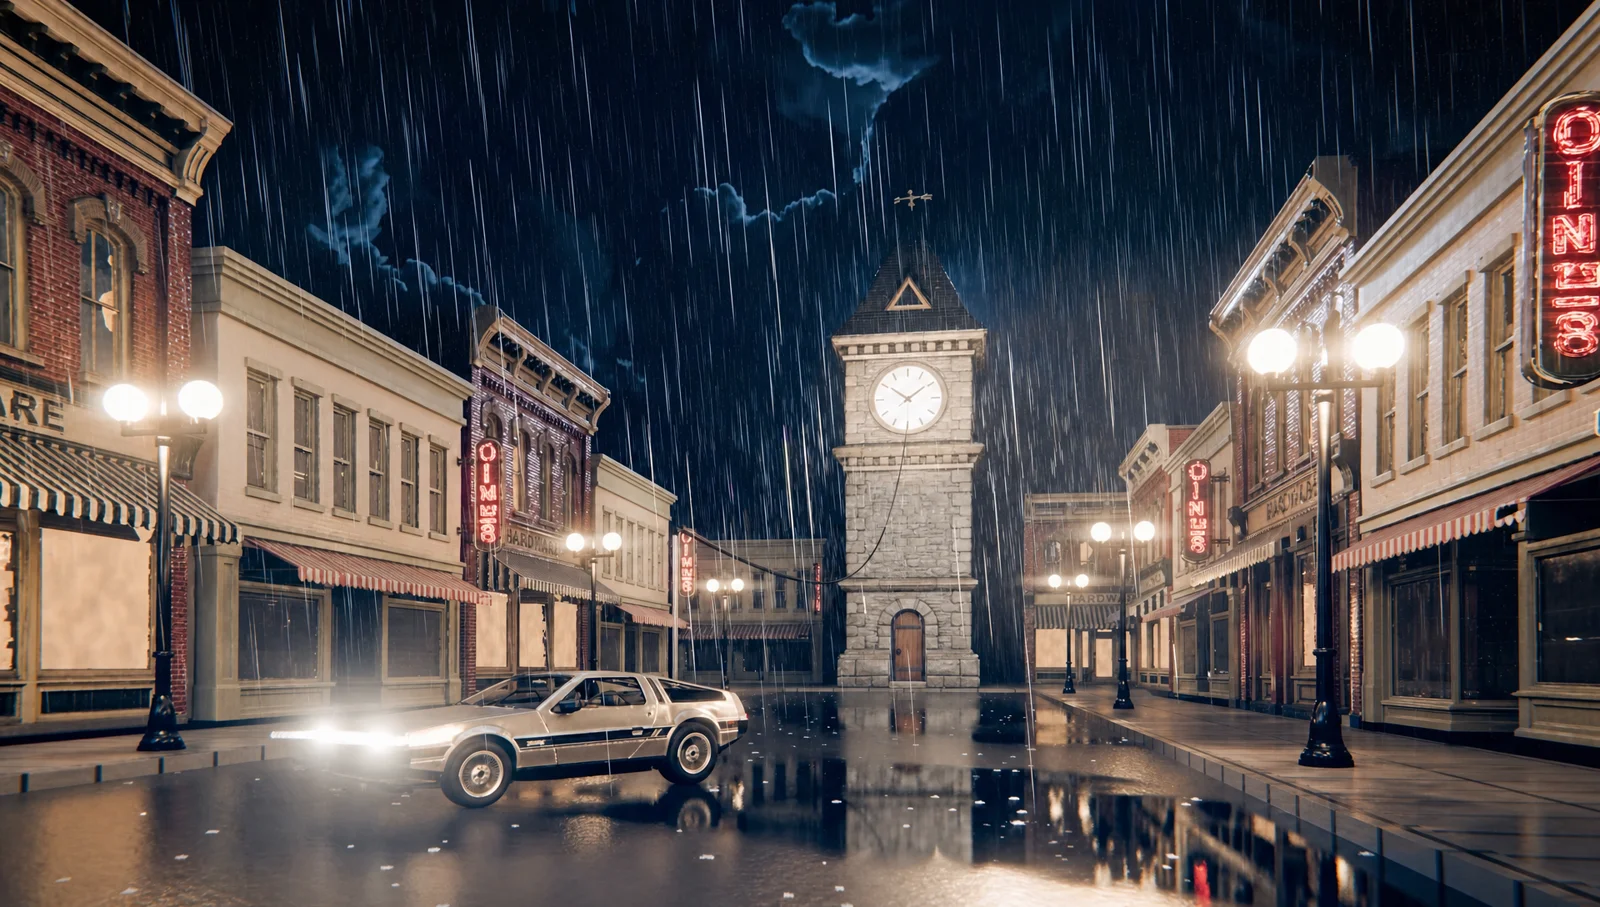
| Escena callejera de película con un DeLorean | Opus 5.5 | Alrededor de 1.5 h y unos $25 cada uno; Opus añadió las estelas de fuego |
| Notre-Dame, totalmente procedural | Empate | GPT-6 Astra tardó 42 minutos, Opus 5.5 tardó 96 |
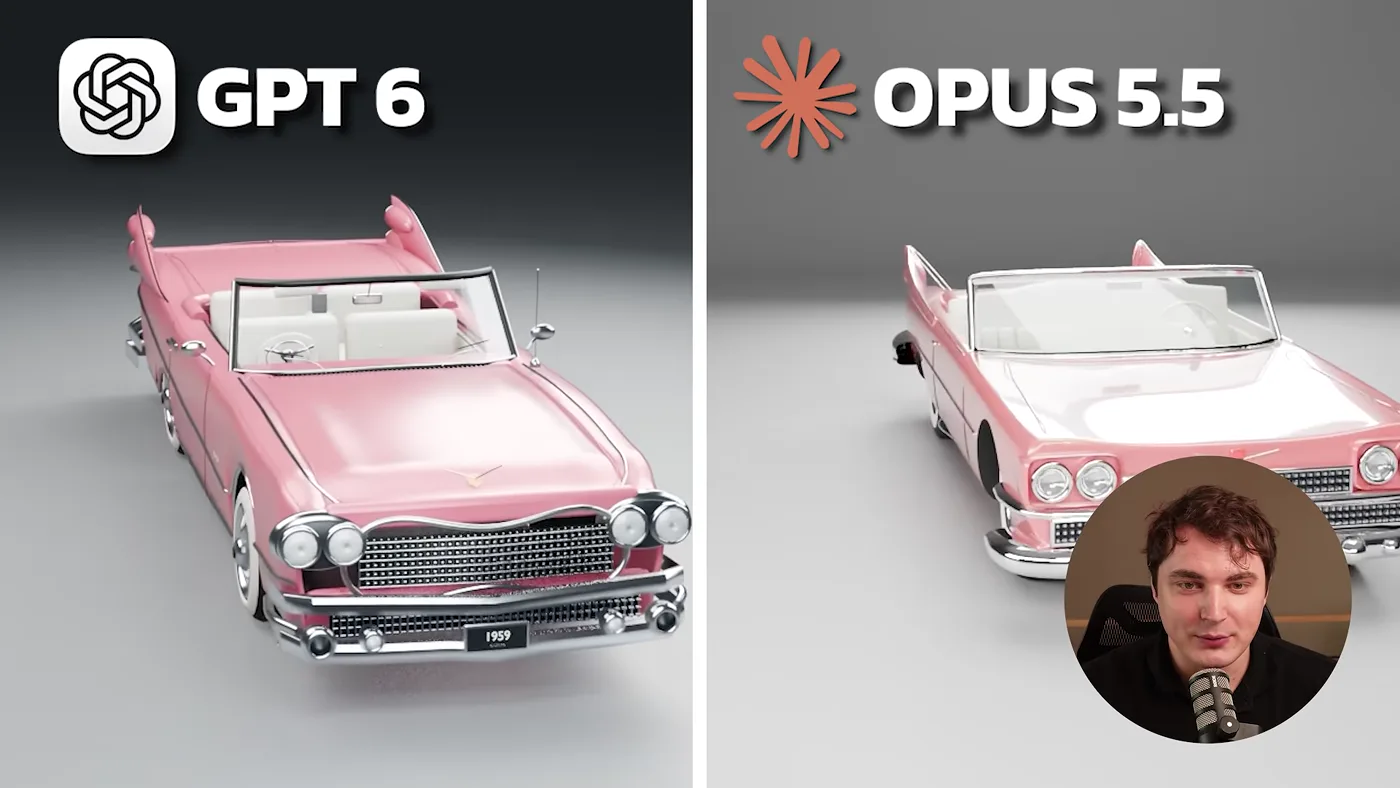
| Cadillac Eldorado, procedural | GPT-6 Astra | Más detalle y mejores luces; mismo tiempo, costo similar |
| Galeón pirata, procedural | GPT-6 Astra | Alrededor de 1 h cada uno; GPT-6 Astra a cerca de la mitad del costo |
| Set de VFX en Three.js | Opus 5.5 | Alrededor de 30 minutos cada uno, pocos tokens |
| Desplegado UV de cuatro assets | Ambos fallaron | Alrededor de 20 minutos y $10 cada uno |
| Caminata, salto y ataque de criatura | Opus 5.5 | 46 minutos frente a 63 |
| Animación de humanoide de Lego | Opus 5.5, por poco | Ninguno fue tan juguetón como esperaba |
| Castillo con fuegos artificiales y un timelapse | Resultado dividido | GPT-6 construyó el castillo más detallado; Opus tuvo el mejor movimiento |
| Juego en HTML de un solo prompt | Opus 5.5 | Mucho más divertido de jugar, pero tomó casi el triple de tiempo y costó casi el triple |
El marcador: cinco para Opus 5.5, dos para GPT-6 Astra y tres pruebas con empate, resultado dividido o fallo compartido. GPT-6 Astra gana cuando el objeto se puede describir con matemáticas: cascos simétricos, molduras cromadas, ventanas que se repiten. Opus 5.5 gana cuando el resultado tiene que moverse o sentirse bien, que es la mayor parte del trabajo en videojuegos.
Por sí solo, GPT-6 Astra sigue siendo el modelo que me hizo replantearme el trabajo 3D en septiembre. Frente a Fable 5.1, le hizo rigging a mi cuadrúpedo con pesos limpios y añadió un rig de control con cinemática inversa que nunca pedí. Reconstruyó un pueblo entero a partir de una sola imagen de referencia, de forma procedimental, en cerca de una hora, con alrededor de 70K caras. Construyó un auto a partir de planos con una animación de ensamblaje y escribió un add-on funcional de Blender en un solo prompt. Más de diez de esas pruebas consumieron cerca del 7% de mi límite semanal en el plan más alto de ChatGPT.
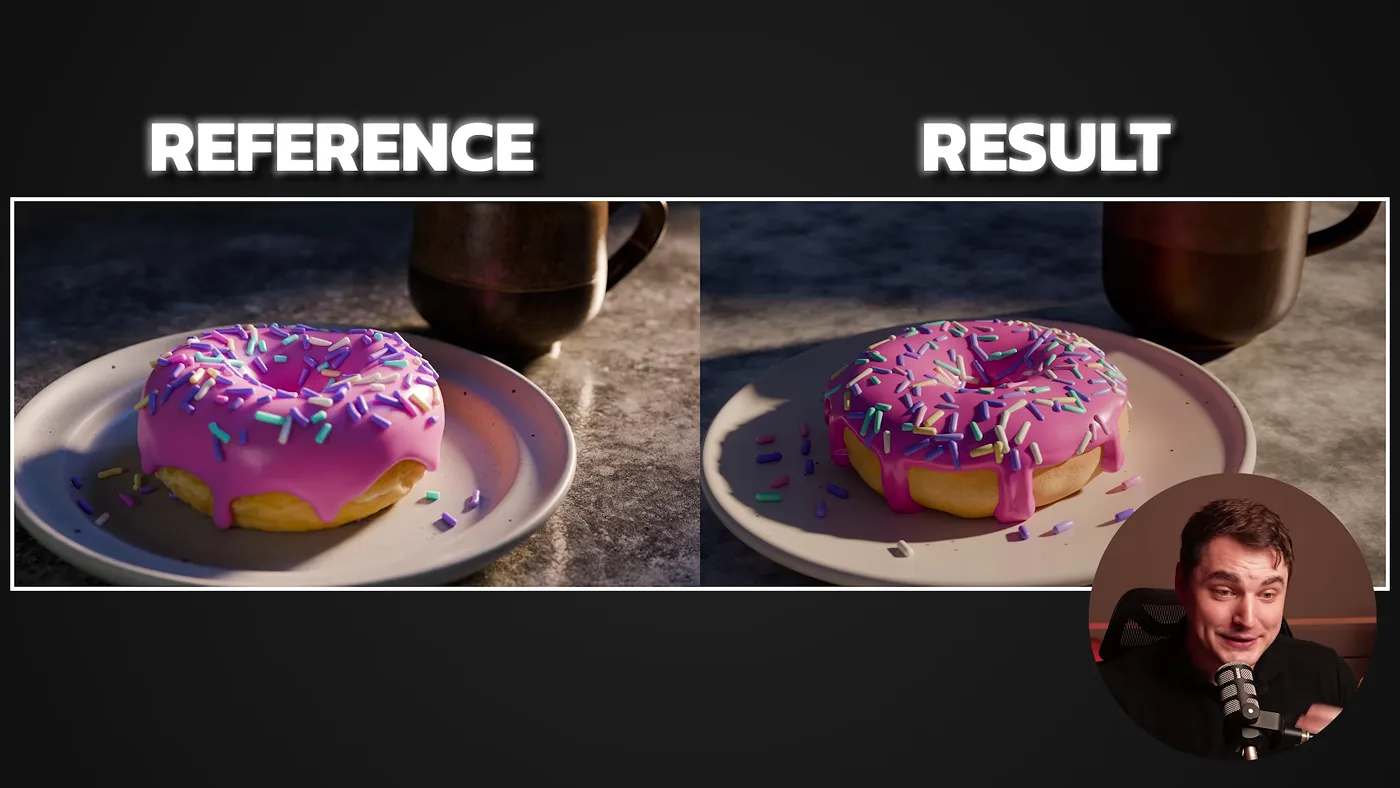
Opus 5.5 se ganó su lugar repitiendo pruebas con las que los mejores modelos batallaron hace un año. Dos rondas de la famosa prueba de la dona tomaron 100 minutos y unos $21, y el resultado de la ronda con imagen de referencia quedó casi idéntico a esa imagen. Una animación de teclado tomó 111 minutos y $23, una isla armada a partir de 13 modelos generados con Tripo tomó 62 minutos y unos $20 más $5.50 por generar los modelos, y un juego de fútbol jugable tomó 23 minutos. Jugué a ese durante 20 minutos y casi no encontré ningún bug.
3. Gemini 4 Argon: la opción económica, con límites
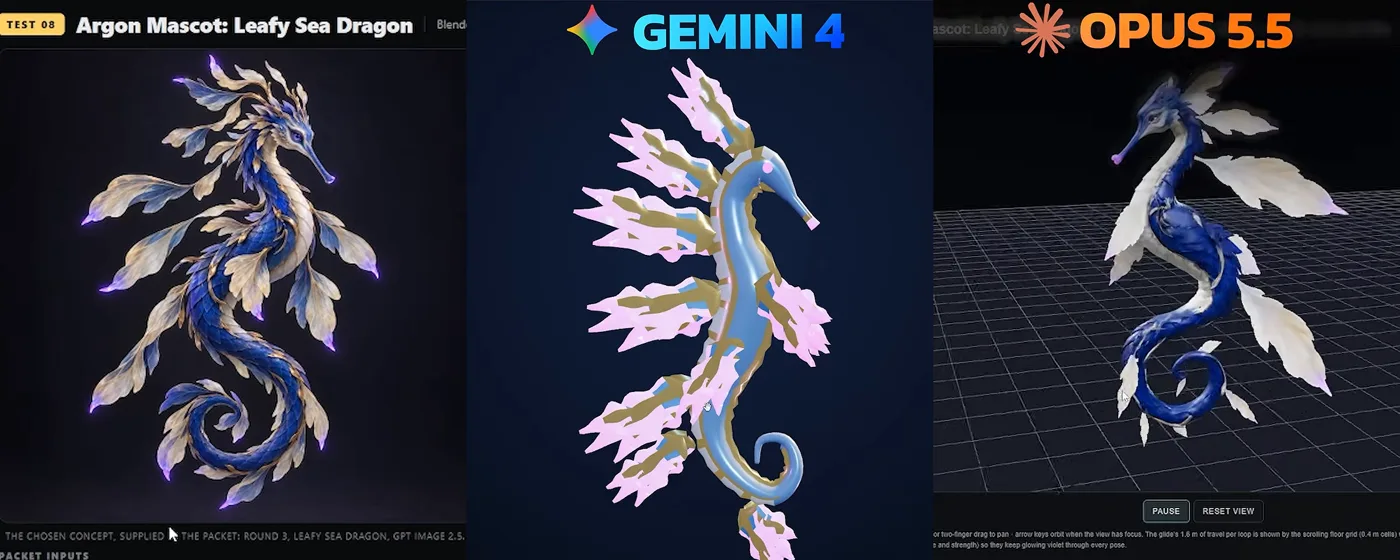
Google prometió mucho para Gemini 4 en 3D, y los benchmarks oficiales lo ubicaron por encima de GPT-6 Astra y Opus 5.5 en la mayoría de ellos. En mis siete pruebas cara a cara contra Opus 5.5 perdió seis en calidad, y la séptima quedó a su favor solo porque Opus interpretó mal mi prompt. También costó entre 4 y 14 veces menos en cada ocasión: $2 frente a $15 por el dragón marino, $1.50 frente a $21.35 por un clon realista de Minecraft.
- Villa de cristal a partir de dos planos: ambos ubicaron todo correctamente, Opus se vio mejor, Gemini costó una cuarta parte.
- Rig y animación del dragón marino: Gemini falló por completo, incluso con acceso a un generador 3D. Opus generó el cuerpo y las hojas y los conectó adecuadamente.
- Fondo de pantalla de acuario, VFX de incienso, clones de Rocket League y Minecraft: Opus en todas las ocasiones, a un precio entre 7 y 14 veces mayor aproximadamente.
- Escena de menú de juego: Gemini entregó una página funcional en 30 minutos por $2; Opus interpretó mal mi prompt y en su lugar creó un archivo de Blender.
Luego, la prueba de Fortnite cambió parte de ese panorama. Construyendo props uno a la vez, Gemini 4 hizo los mejores modelos individuales de los cuatro y terminó segundo en general, con la mejor respuesta de impacto y la mejor destrucción. El precio fue la velocidad: trabajó en los props durante casi 14 horas, mientras que Opus terminó el mismo set en unas 4.
4. Un juego completo: Opus 5.5 vs GPT-6.1 vs Gemini 4 vs Muse
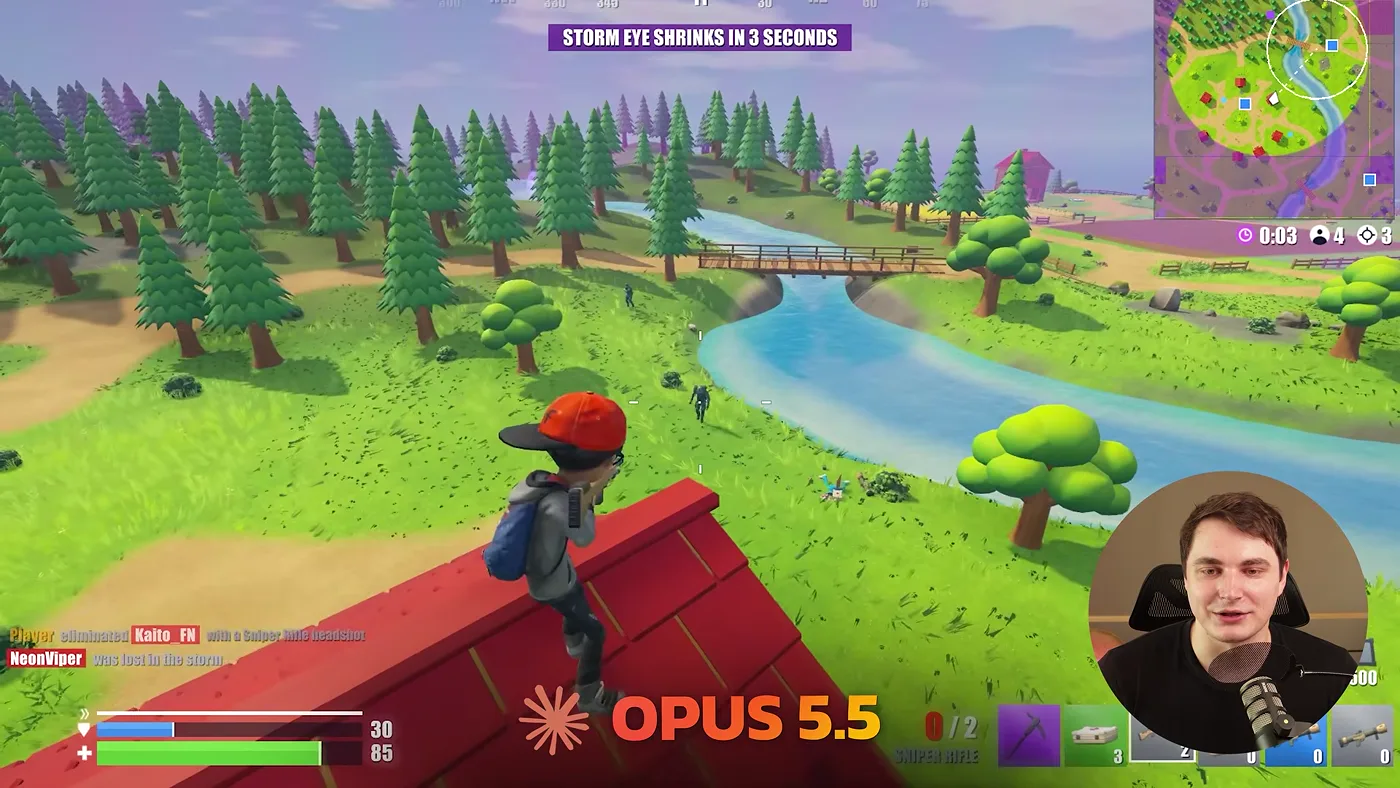
Cuando se trata de crear un juego completo, los modelos se desmoronan. Le pedí a cuatro modelos que reconstruyeran Fortnite en Unity en tres etapas: un set de props, el mapa y luego el juego completo. Mismos prompts, Blender más la Unity CLI como herramientas, Mixamo para personajes y animación, y nada de generadores 2D o 3D para que los modelos tuvieran que hacer el trabajo por sí mismos. Se permitieron prompts de seguimiento; toda la prueba tomó tres días.
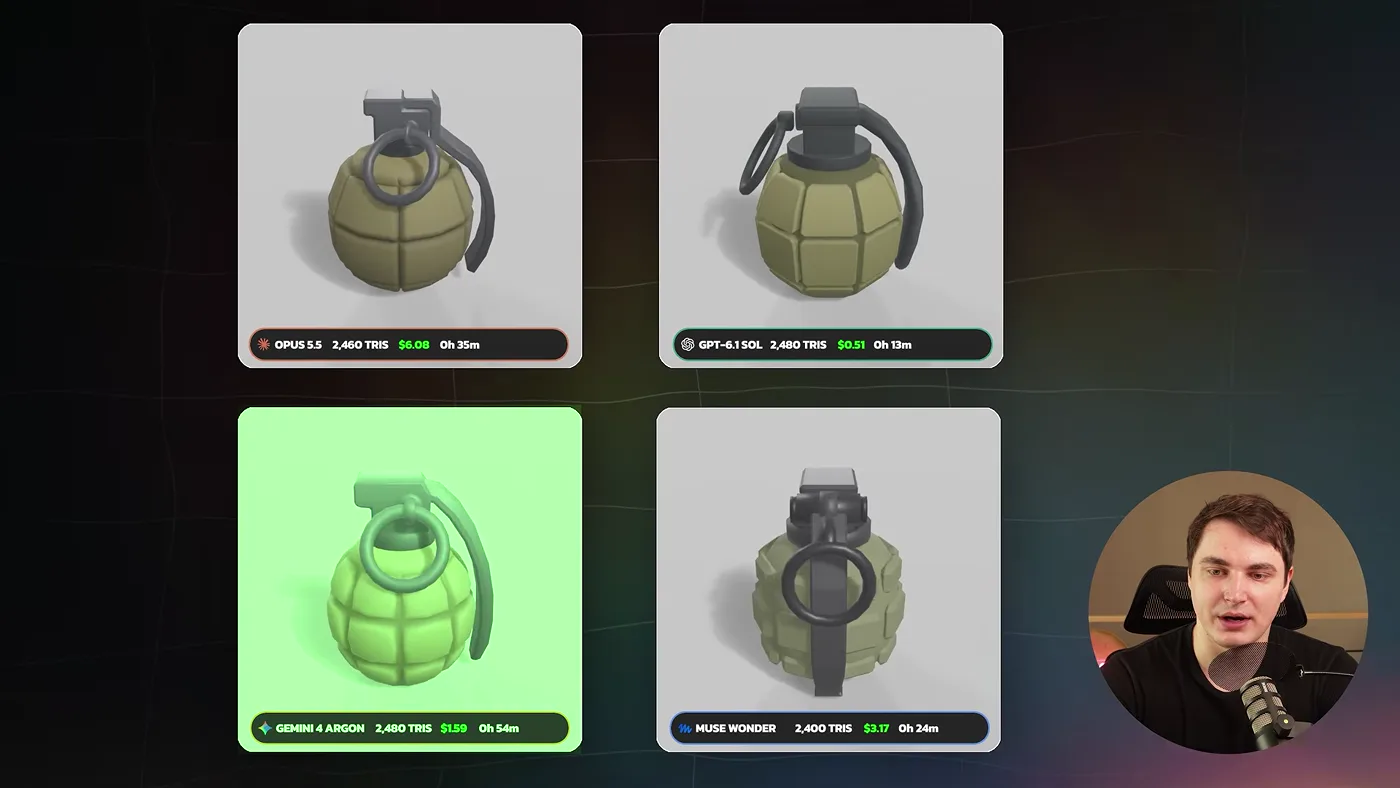
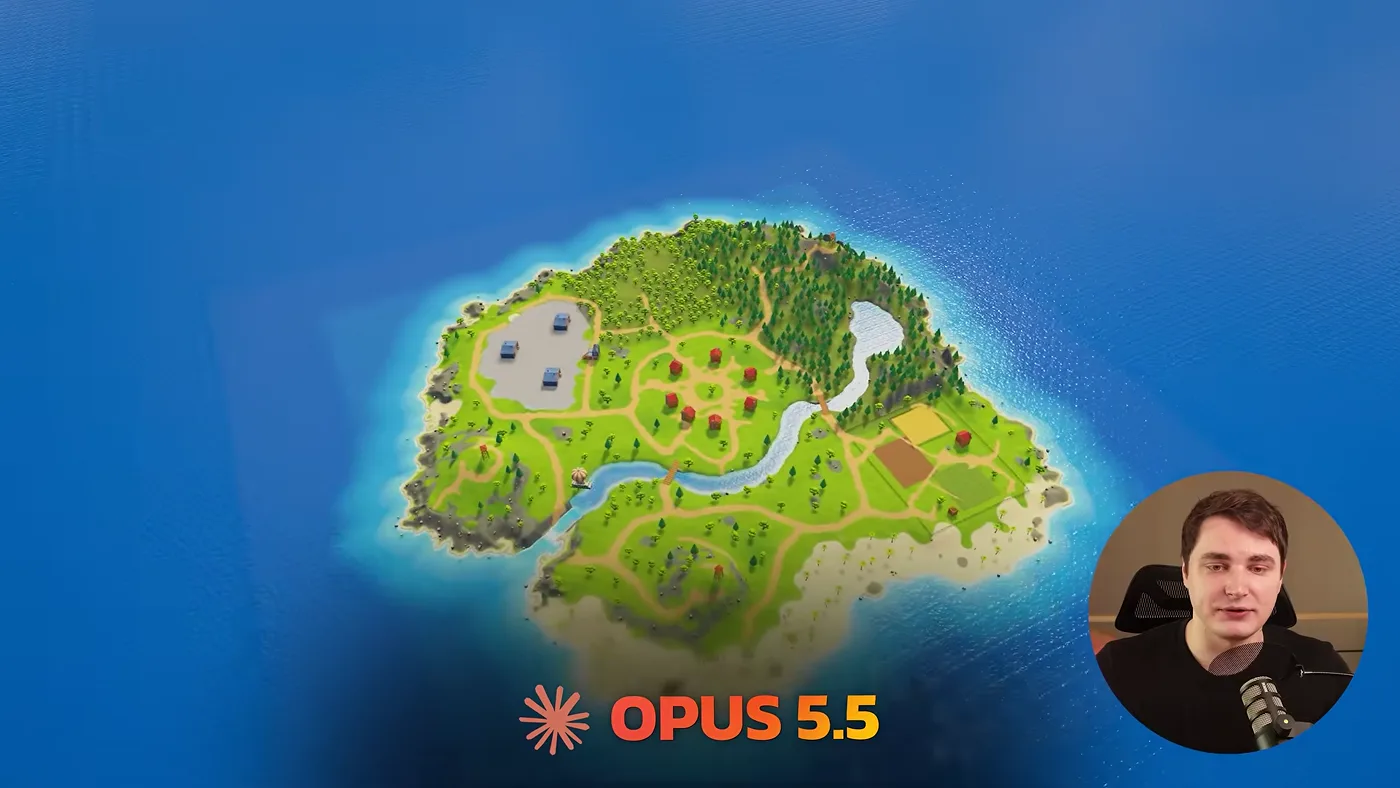
| Puesto | Modelo | Props | Mapa | Juego | Tiempo del agente | Tokens | Costo de API |
|---|---|---|---|---|---|---|---|
| 1 | Claude Opus 5.5 | 2nd | 1st | 1st | 23 h 59 m | 778.9M | $282.29 |
| 2 | Gemini 4 Argon | 1st | 2nd | 2nd | 39 h 33 m | 302.7M | $132.59 |
| 3 | Meta Muse Wander | 4th | 4th | 3rd | alrededor de 30 h | alrededor de 183M | $191.71 |
| 4 | GPT-6.1 Sol | 2nd | 3rd | 4th | 41 h 50 m | 280.7M | $93.82 |
Opus 5.5 fue el más caro y también el más rápido: 778.9 millones de tokens y $282 en menos de 24 horas de tiempo del agente. GPT-6.1 Sol fue el más barato con $94, pero fue el que más tardó y su juego se sentía acartonado en todos los aspectos: un rifle congelado, sin feedback al recoger objetos, un misil en lugar de una bala. Muse Wander se veía como el más simple, pero se jugaba mejor que Sol, y la IA que compiló mis reportes estuvo de acuerdo.
5. Modelos de pesos abiertos: Kimi K3.1 Pro y DeepSeek 4.1
El código abierto está de vuelta en 3D. Según las propias cifras de Moonshot, Kimi K3.1 Pro se ubica segundo en Terminal Bench, justo detrás de Opus 5.5, así que lo puse a prueba junto con DeepSeek 4.1 Flash frente a Gemini 4 y Opus 5.5 en nueve pruebas. Ejecuté ambos modelos abiertos dentro del harness de Claude Code: en sus propios harnesses (Kimi Code, por ejemplo) son más baratos, pero también más perezosos, porque Claude Code lleva al modelo a iterar.
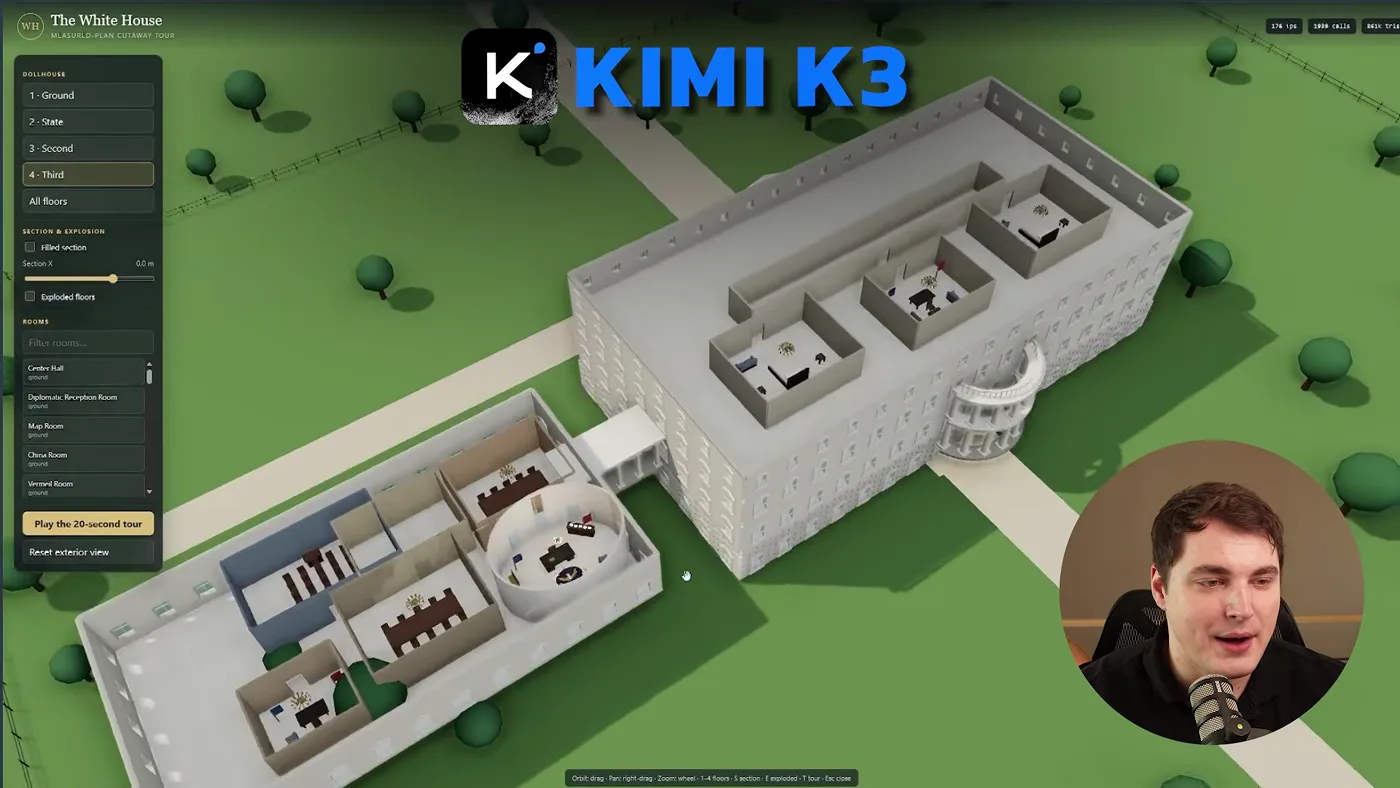
- Opus 5.5 aun así ganó la mayoría de las pruebas: el alunizaje del Apollo, la Casa Blanca explorable, el ensamblaje de la Kawasaki H2 y la ballena saltando.
- Kimi K3.1 Pro quedó cerca de Gemini 4, y lo superó en la transformación de auto a robot. Eligió el camino difícil en la grulla de origami y terminó segundo, y su juego de planetas diminutos tuvo los controles mejor logrados de los cuatro.
- DeepSeek 4.1 no costó casi nada y creó un juego de pinball sorprendentemente bueno; la bola de Gemini 4 se atascó todas las veces.
- La advertencia sobre el precio: a través de la Kimi API, las lecturas de caché ($0.20 por millón de tokens) acercaron los costos de mis pruebas a los de Opus 5.5. A través de Kimi Code o en tu propio hardware es mucho más barato; por token es unas 5 veces más barato que GPT-6 Astra.
DeepSeek ya liberó sus pesos, y Moonshot dijo que los pesos de Kimi K3 llegarían a Hugging Face a principios de noviembre. En una ronda anterior en agosto, Grok quedó por delante de los modelos de pesos abiertos GLM 5.3 y Qwen 3.8 Max. GLM 5.3 era bueno, pero su API seguía fallando con el nivel de esfuerzo al máximo, y Qwen 3.8 Max fue el que más falló. Si necesitas mantener el trabajo en tus propios servidores, GLM 5.3 y Kimi K3.1 son los que deberías probar.
6. La configuración importa tanto como el modelo
Cada resultado en esta página depende de cómo el modelo se conecta con Blender. Antes de culpar a un modelo, revisa estas tres cosas.
- MCP, no computer use. Con computer use, GPT-6 Astra necesitó 10 minutos solo para guardar un archivo. Un servidor MCP (el MCP oficial de Blender o el Higgsfield Blender plugin gratuito) le permite al modelo llamar a Blender directamente y ver la escena.
- La CLI propia del modelo con el nivel de esfuerzo al máximo. Claude Code para Opus, Codex CLI para GPT-6, la Antigravity CLI para Gemini. Las ventanas de chat no pueden ejecutar tu escena.
- Generadores 3D cuando la calidad importa. Los prohibí en la prueba de Fortnite para medir a los modelos; para trabajo de producción, permitir que el agente llame a Tripo P2 o Hi3D da assets mucho mejores que las primitivas.
Ejecuto todo esto desde mi espacio de trabajo gratuito, Mr Mak Workspace en GitHub, que ahora soporta Claude Code, Codex y Antigravity lado a lado. Las guías de instalación completas están en la configuración de GPT-6 Astra y la configuración de Claude + Blender.
7. Dónde siguen fallando todos los modelos
Cuánto cuesta y cuánto tiempo toma
En junio, Opus 4.8 y GPT-5 todavía tenían dificultades para colocar objetos prefabricados con la rotación correcta. Hoy, Opus 5.5 y GPT-6 Astra construyen escenas completas, hacen el rigging de criaturas y entregan juegos a los que se puede jugar, y la diferencia entre ellos se reduce al gusto y al presupuesto. Mi opción por defecto es Opus 5.5 para todo lo que se mueva y GPT-6 Astra para todo lo que tenga cromo. Uso Gemini 4 para generar lotes económicos de props y sigo de cerca a Kimi, esperando el día en que los modelos con pesos abiertos alcancen a los demás.
Guías relacionadas en este sitio: la configuración de GPT-6 Astra para 3D, la configuración de Claude + Blender, cómo Kimi K3 crea diez juegos en Unity y cómo un LLM local gratuito crea un juego en Unreal Engine 5.8.
Cada prueba, en YouTube
- 7 de nov. de 2026 Fortnite in Unity: Opus 5.5 vs GPT-6.1 vs Gemini 4 vs Muse
- 25 de oct. de 2026 Kimi K3.1 Pro vs DeepSeek 4.1 vs Gemini 4 vs Opus 5.5
- 15 de oct. de 2026 Gemini 4 Argon vs Opus 5.5 in 3D and Blender
- 27 de sep. de 2026 Opus 5.5 reruns my Blender tests from a year ago
- 24 de sep. de 2026 Claude Opus 5.5 vs GPT-6 Astra: 10 Blender tests
- 7 de sep. de 2026 GPT-6 Astra in Blender (vs Fable 5.1)
- 26 de ago. de 2026 GLM 5.3, Qwen 3.8 Max and Grok on 3D tasks
Última actualización: 9 de noviembre de 2026. Siguientes en la lista: Gemini 4 Carbon y Muse Wonderful, una vez que tenga acceso.